99 Ngày Java — Ngày 45: File I/O với java.io
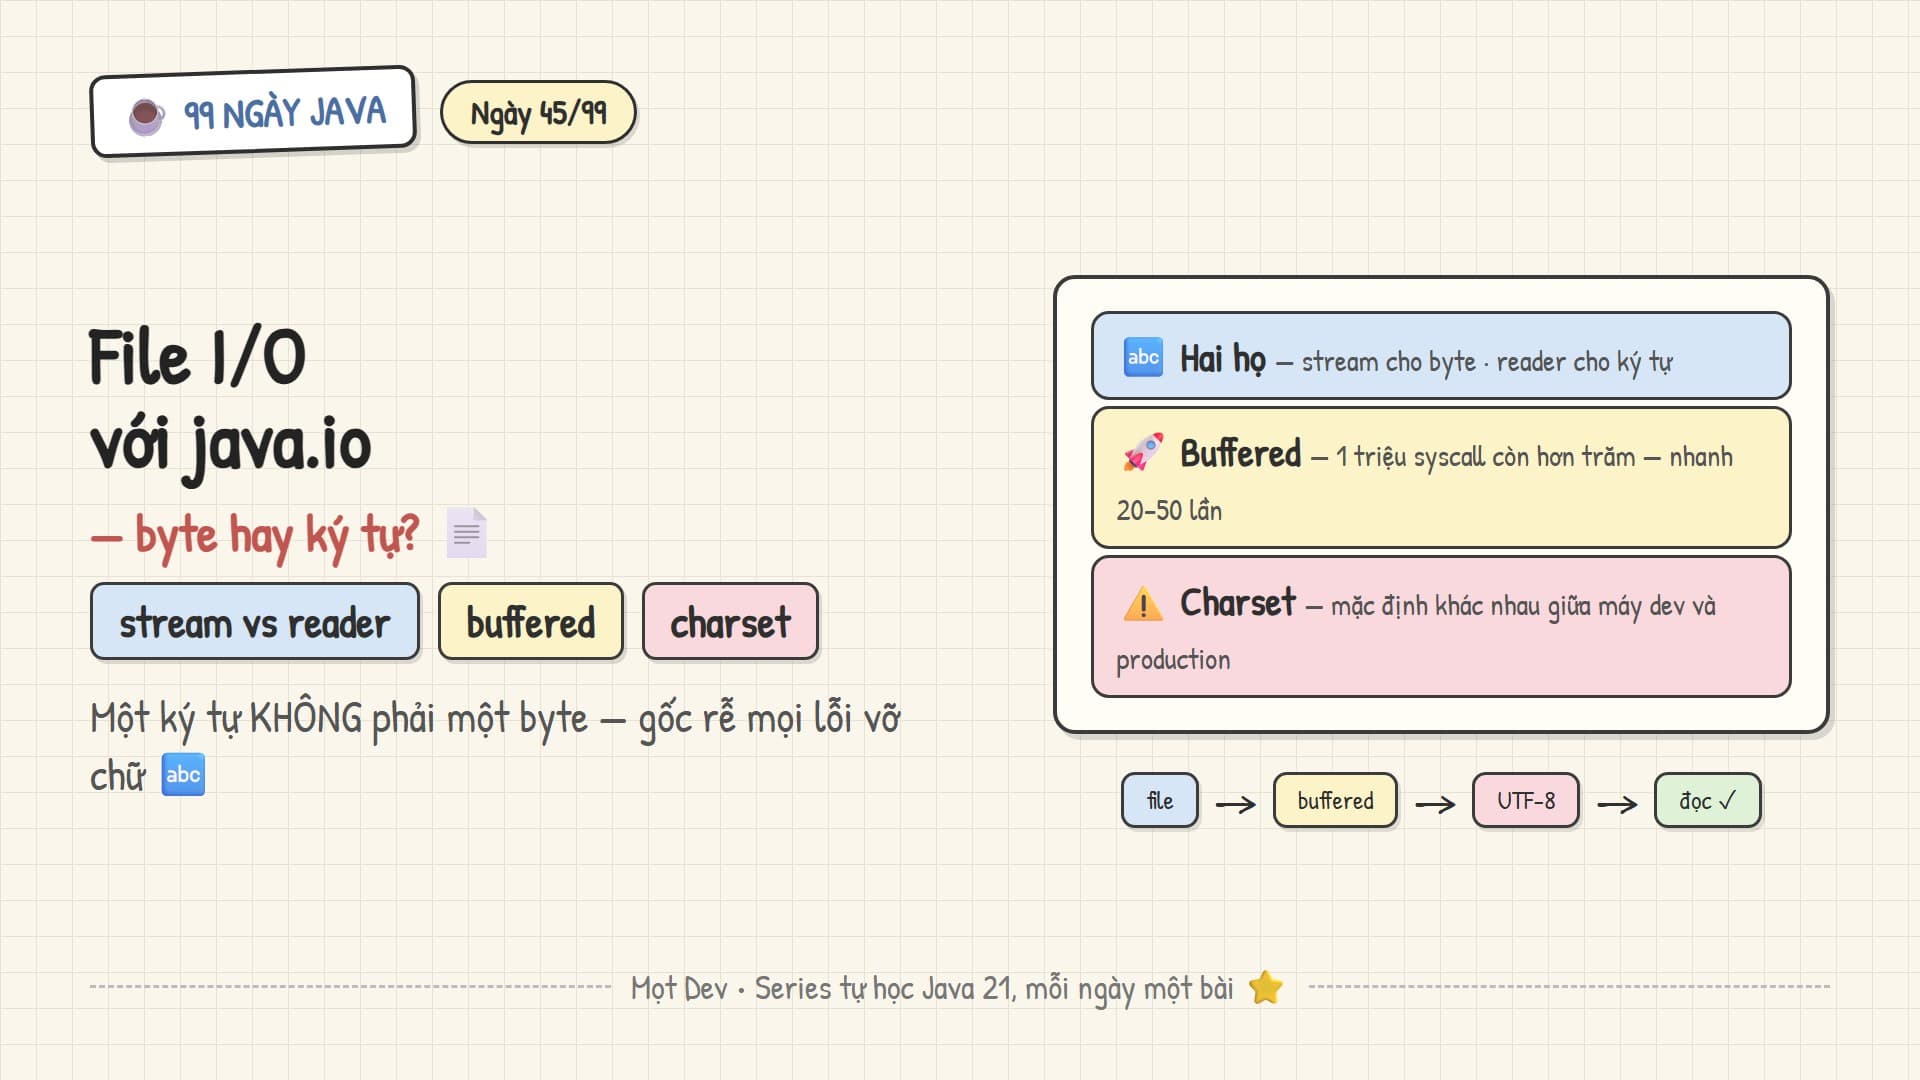
Hôm nay là bài I/O đầu tiên của series, và cũng là nơi ba bài học gần đây gặp nhau: try-with-resources của Ngày 44 để không rò rỉ, IOException của Ngày 41 là checked nên buộc phải có kế hoạch, và giờ thêm ba quyết định của riêng I/O — stream hay reader, có buffered hay không, và charset, cái bẫy làm vỡ tiếng Việt mà gần như ai cũng dính một lần.
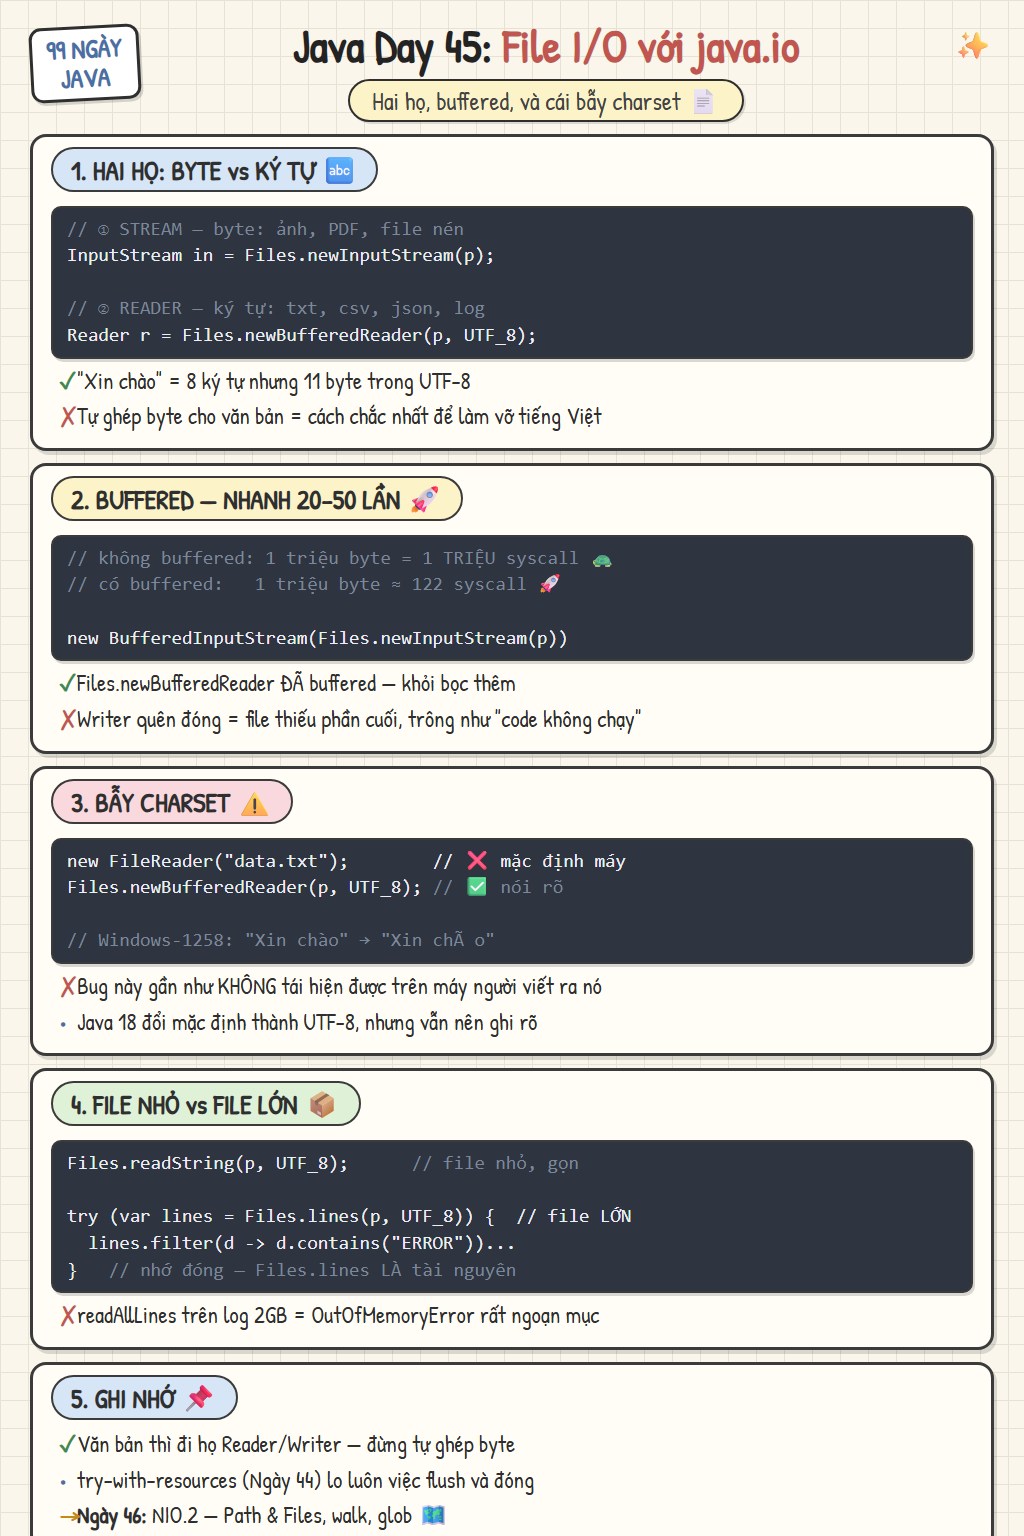
Hai họ: stream cho byte, reader cho ký tự
Người mới hay bối rối vì java.io có quá nhiều class. Nhưng thật ra chỉ cần nhớ hai họ, và câu hỏi để chọn cũng chỉ có một: dữ liệu này là nhị phân hay là văn bản?
// java.io chia làm HAI HỌ, và chọn nhầm họ là nguồn gốc của lỗi tiếng Việt bị vỡ:

// ① STREAM — làm việc với BYTE. Dùng cho dữ liệu NHỊ PHÂN:
//    ảnh, PDF, file nén, dữ liệu mạng
InputStream  in  = Files.newInputStream(duongDan);
OutputStream out = Files.newOutputStream(dich);

// ② READER / WRITER — làm việc với KÝ TỰ. Dùng cho VĂN BẢN:
//    txt, csv, json, log
Reader r = Files.newBufferedReader(duongDan, StandardCharsets.UTF_8);
Writer w = Files.newBufferedWriter(dich, StandardCharsets.UTF_8);

// Vì sao phải tách? Vì một ký tự KHÔNG PHẢI một byte.
// "Xin chào" trong UTF-8: 8 ký tự nhưng 11 byte (các ký tự có dấu tốn 2–3 byte).
// Đọc văn bản bằng InputStream rồi tự ghép byte là cách chắc chắn nhất
// để làm vỡ tiếng Việt — cắt giữa chừng một ký tự nhiều byte thì ra "?".

// Cầu nối giữa hai họ khi cần: InputStreamReader / OutputStreamWriter
new InputStreamReader(in, StandardCharsets.UTF_8);   // byte → ký tự

// QUY TẮC: dữ liệu là văn bản thì đi họ Reader/Writer. Đừng tự ghép byte.
Một ký tự không phải một byte:
"Xin chào"là 8 ký tự nhưng 11 byte trong UTF-8 — đây chính là gốc rễ của mọi lỗi vỡ chữ.Ảnh, PDF, file nén thì đi họ stream; còn txt, csv, json, log thì đi họ reader/writer.
InputStreamReaderlà cây cầu khi bạn nhận được byte nhưng biết chắc đó là văn bản — và luôn nhớ truyền charset.
Buffered — một lớp bọc, nhanh gấp hàng chục lần
Đây là chỗ khác biệt về hiệu năng lớn nhất trong toàn bộ java.io, và nó không phải tối ưu vặt: bọc thêm một lớp buffered thường làm chương trình nhanh hơn vài chục lần trên file cỡ vài megabyte.
// BUFFERED — một lớp bọc, và là khác biệt hàng chục lần về tốc độ.

// KHÔNG buffered: mỗi lần read() là MỘT lần gọi hệ điều hành
try (var in = Files.newInputStream(duongDan)) {
    int b;
    while ((b = in.read()) != -1) { ... }      // 1 triệu byte = 1 triệu syscall 🐢
}

// CÓ buffered: đọc cả khối 8KB vào bộ nhớ, rồi phát dần từ đó
try (var in = new BufferedInputStream(Files.newInputStream(duongDan))) {
    int b;
    while ((b = in.read()) != -1) { ... }      // 1 triệu byte ≈ 122 syscall 🚀
}
// Trên file 10MB, khoảng cách thường là 20–50 lần. Không phải tối ưu vặt.

// Vì sao? Mỗi syscall là một lần chuyển từ user space sang kernel space —
// đắt hơn rất nhiều so với đọc từ một mảng byte có sẵn trong bộ nhớ.

// Files.newBufferedReader ĐÃ buffered sẵn, khỏi bọc thêm:
try (var br = Files.newBufferedReader(duongDan, UTF_8)) {
    String dong;
    while ((dong = br.readLine()) != null) { ... }
}

// ❗ Với WRITER thì buffered còn kéo theo một chuyện nữa: FLUSH.
// Dữ liệu nằm trong bộ đệm cho tới khi đầy, hoặc tới khi bạn gọi flush()/close().
// Quên đóng → file thiếu phần cuối, và trông như "code không chạy".
// try-with-resources (Ngày 44) lo việc này giúp bạn — đó là lý do luôn dùng nó.
Không buffered thì mỗi
read()là một lệnh gọi hệ điều hành; có buffered thì một triệu byte chỉ tốn hơn trăm lệnh gọi.Files.newBufferedReaderđã buffered sẵn — bọc thêmBufferedReadernữa là thừa.Với writer, buffered kéo theo chuyện flush: quên đóng thì file thiếu phần cuối, và triệu chứng nhìn y hệt "code không chạy".
try-with-resourcescủa Ngày 44 lo luôn việc flush và đóng — thêm một lý do để luôn dùng nó.
Charset và cách đọc file lớn
Nếu hôm nay bạn chỉ nhớ một dòng, hãy nhớ dòng này: luôn ghi rõ charset. Không ghi thì Java dùng mặc định của máy, mà mặc định thì khác nhau giữa máy bạn và máy chạy production — và bug loại này gần như không tái hiện được trên máy của người viết ra nó.
// CHARSET — cái bẫy kinh điển với tiếng Việt.

new FileReader("data.txt");                       // ❌ dùng charset MẶC ĐỊNH của máy
Files.newBufferedReader(duongDan);                // ❌ (trước Java 18 cũng vậy)
Files.newBufferedReader(duongDan, UTF_8);         // ✅ LUÔN nói rõ

// Vì sao nguy hiểm: charset mặc định phụ thuộc HỆ ĐIỀU HÀNH và LOCALE.
//   máy dev (macOS/Linux)     → UTF-8   → chạy ngon
//   máy Windows tiếng Việt cũ → windows-1258 → "Xin chào" thành "Xin chà o"
// Cùng một file, cùng một đoạn code, hai kết quả khác nhau. Bug kiểu này
// gần như không thể tái hiện trên máy của người viết ra nó.

// Java 18 đổi mặc định thành UTF-8 (JEP 400) — nhưng ĐỪNG dựa vào đó:
// code của bạn có thể chạy trên JVM cũ, và người đọc code không đoán được ý bạn.
// Nói rõ charset là tự tài liệu hóa.

// ĐỌC/GHI GỌN cho file nhỏ (nhỏ hơn vài chục MB):
String noiDung = Files.readString(duongDan, UTF_8);
List<String> dong = Files.readAllLines(duongDan, UTF_8);
Files.writeString(dich, noiDung, UTF_8);

// ❗ File LỚN thì ĐỪNG readAllLines — nó nạp TOÀN BỘ vào RAM.
// File log 2GB sẽ cho bạn một OutOfMemoryError rất ngoạn mục.
try (var lines = Files.lines(duongDan, UTF_8)) {      // đọc lười, từng dòng
    lines.filter(d -> d.contains("ERROR")).forEach(System.out::println);
}   // ❗ nhớ đóng — Ngày 44 đã nói: Files.lines LÀ tài nguyên
Java 18 đã đổi mặc định thành UTF-8, nhưng vẫn nên ghi rõ: code có thể chạy trên JVM cũ, và người đọc không phải đoán ý bạn.
Files.readStringvàFiles.writeStringgọn cho file nhỏ — nhưng chúng nạp toàn bộ vào RAM.File lớn thì dùng
Files.linesđể đọc lười từng dòng — và nhớ đóng nó, vì nó là tài nguyên (Ngày 44).
Bài tập nhỏ
Ghi một file tiếng Việt bằng
UTF-8rồi đọc lại bằngISO-8859-1— nhìn tận mắt chữ vỡ thành ký tự lạ.Đo thời gian đọc từng byte một file 10MB có và không có
BufferedInputStream.Ghi vào file bằng
BufferedWriterrồi cố tình không đóng — mở file lên xem thiếu bao nhiêu.Đọc một file log lớn bằng
readAllLinesvới heap nhỏ để gặpOutOfMemoryError, rồi đổi sangFiles.lines.Đếm số ký tự và số byte của chuỗi
"Xin chào"để tự thấy vì sao hai họ phải tách nhau.
Kết lại
Bốn ý gói lại hôm nay: java.io chia làm stream cho byte và reader cho ký tự, chọn sai họ là làm vỡ chữ có dấu; buffered biến một triệu lệnh gọi hệ điều hành thành hơn trăm — nhanh hơn hàng chục lần chứ không phải tối ưu vặt; luôn ghi rõ charset, vì mặc định khác nhau giữa máy dev và máy production; và file lớn thì đọc lười bằng Files.lines thay vì nạp hết vào RAM, nhớ đóng vì nó là tài nguyên. Ngày 46 ta lên tầng API hiện đại hơn: NIO.2 với Path và Files — duyệt cây thư mục, glob, và theo dõi thay đổi. Hẹn gặp lại!
Site Admin
Engineer and writer. Building things with TypeScript and distributed systems.
Bình luận (0)
Bạn cần đăng nhập bằng Google để bình luận.
Hãy là người bình luận đầu tiên.