99 Ngày Java — Ngày 59: Parallel stream
Ngày 54 đã cảnh báo: parallelStream không phải nút tăng tốc. Hôm nay mở nắp xem vì sao — ai thật sự chạy nó, dữ liệu bị chia ra sao, rồi ghép lại thế nào — để trả lời câu hỏi thực dụng nhất: khi nào một chữ .parallel() cho bạn bốn lần nhanh hơn, và khi nào nó làm cả ứng dụng chậm đi. Cùng với đó là cái bẫy giết nhiều production nhất của Stream API: lambda có trạng thái — tuần tự thì đúng, song song thì sai, và test của bạn vẫn xanh.
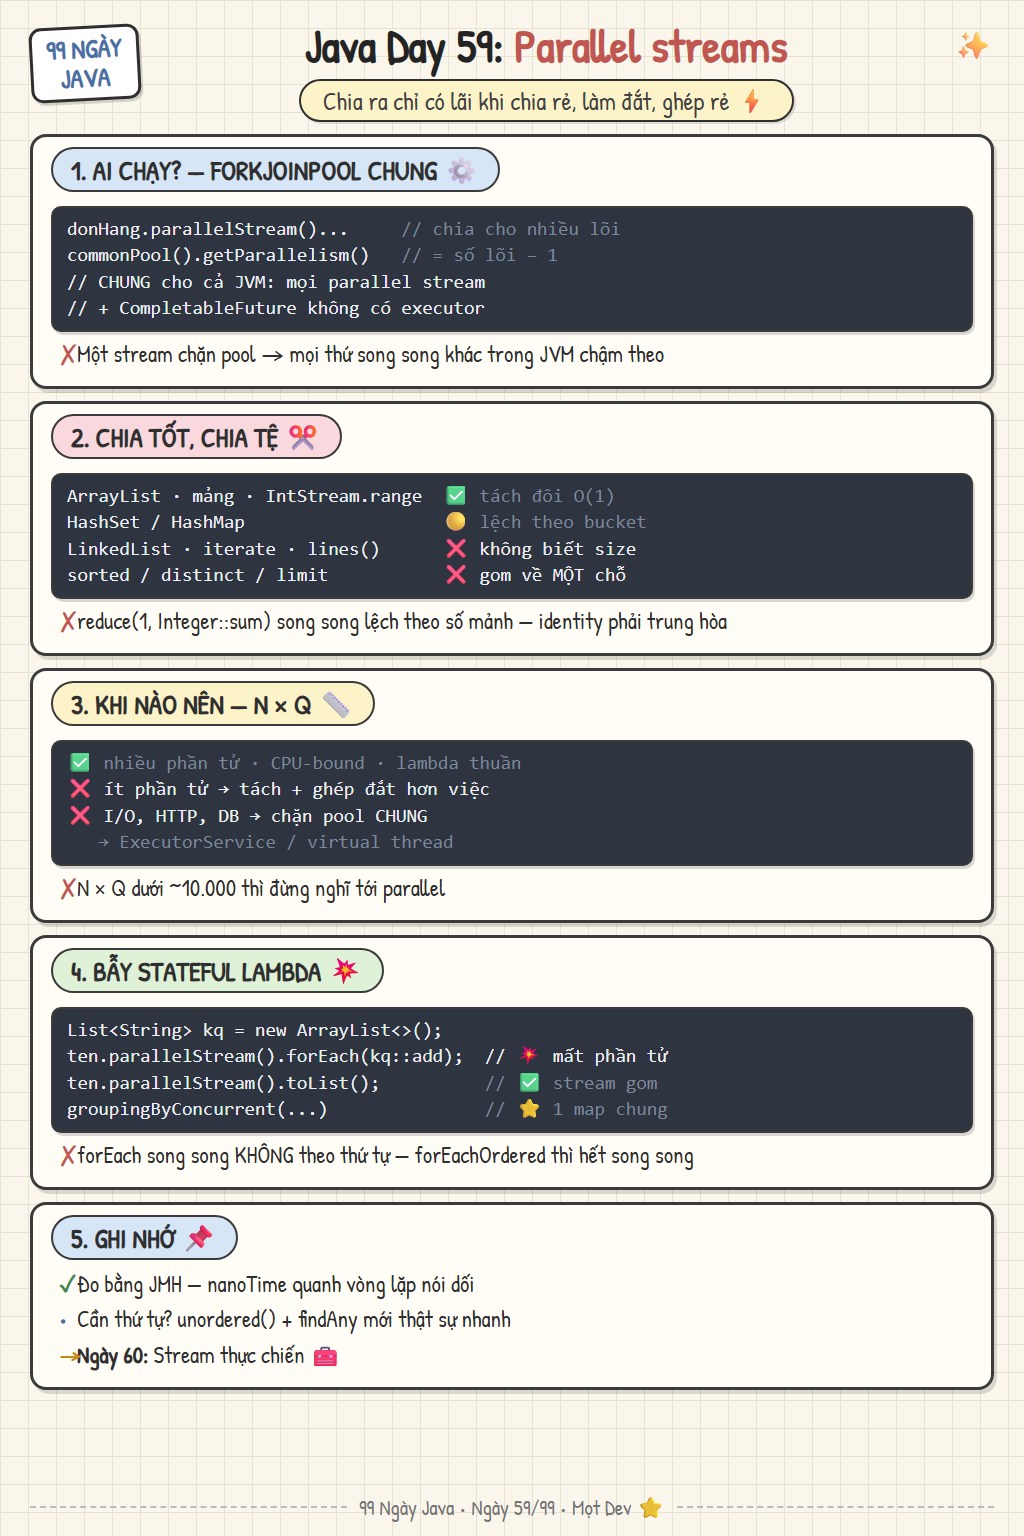
Ai chạy, chia thế nào, ghép ra sao
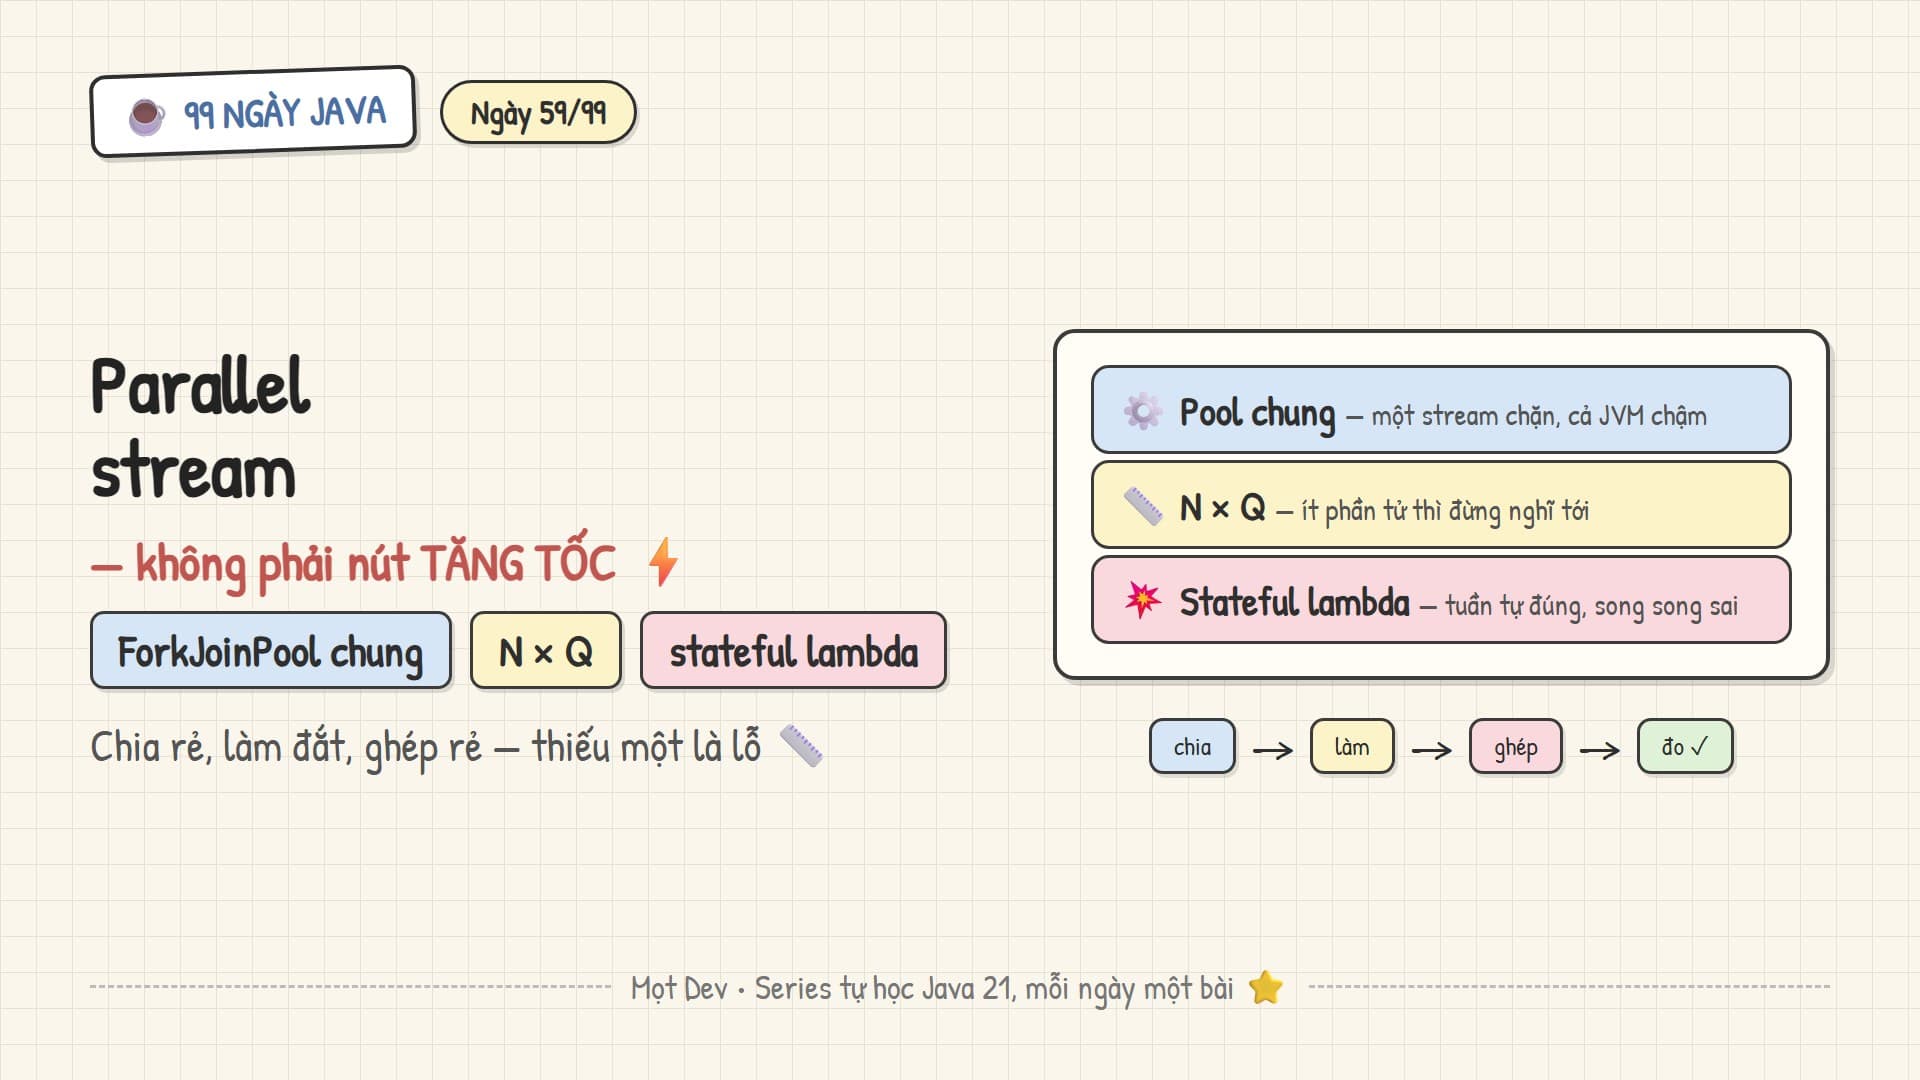
Một parallel stream là ba việc: chia nguồn thành các mảnh, làm mỗi mảnh trên một luồng của ForkJoinPool.commonPool(), rồi ghép các kết quả con lại. Pool đó dùng chung cho cả JVM với CompletableFuture và mọi parallel stream khác; việc chia do Spliterator của nguồn quyết định — ArrayList tách đôi trong O(1), LinkedList thì không biết mình dài bao nhiêu; và việc ghép rẻ với count hay sum, đắt với sorted hay distinct.
// PARALLEL STREAM — cùng dây chuyền, chia cho nhiều lõi. Khác đúng MỘT lời gọi.

List<DonHang> donHang = ...;                                   // 5 triệu đơn
long soQuaHan  = donHang.stream().filter(DonHang::quaHan).count();          // tuần tự: một luồng đi hết
long soQuaHan2 = donHang.parallelStream().filter(DonHang::quaHan).count();  // song song: chia nhỏ, nhiều lõi
donHang.stream().parallel()...    // cùng ý — .parallel() bật, .sequential() tắt, lời gọi SAU cùng thắng

// ① AI CHẠY? — ForkJoinPool.commonPool(), dùng CHUNG cho cả JVM.
System.out.println(ForkJoinPool.commonPool().getParallelism());   // = số lõi − 1 (máy 8 lõi → 7)
// + luồng đang gọi cũng xắn tay làm → tối đa 8 luồng làm việc.
// ❗ CHUNG nghĩa là: mọi parallel stream, mọi CompletableFuture.supplyAsync() không truyền executor,
//    đều xếp vào MỘT pool. Một stream chặn pool là mọi thứ song song khác trong JVM chậm theo.

// ② CHIA THẾ NÀO? — Spliterator: "iterator biết TÁCH ĐÔI". Nguồn quyết định chia tốt hay tệ.
//    ArrayList / mảng / IntStream.range        → tách đôi O(1), hai nửa cân đều      ✅ chia tốt
//    HashSet / HashMap                         → tách theo bucket, các mảnh hơi lệch  🟡
//    LinkedList / Stream.iterate / lines()     → không biết kích thước, phải đọc tuần tự
//                                                 để tách → mảnh lệch, chia đắt        ❌ chia tệ
IntStream.rangeClosed(1, 1_000_000).parallel().sum();              // ✅ chia hoàn hảo
Stream.iterate(1, n -> n + 1).limit(1_000_000).parallel().count(); // ❌ chậm hơn cả tuần tự

// ③ GHÉP LẠI — mỗi mảnh cho một kết quả riêng, rồi "gấp" (combine) lại.
//    count, sum, max, anyMatch      → gấp rẻ                                   ✅
//    collect(toList())              → mỗi mảnh một ArrayList, rồi addAll       🟡 tốn bộ nhớ
//    sorted / distinct              → phải gom về MỘT chỗ mới quyết được       ❌ mất gần hết lợi ích
//    reduce(identity, op)           → identity phải TRUNG HÒA, op phải KẾT HỢP (Ngày 56):
so.parallelStream().reduce(1, Integer::sum);       // ❌ mỗi mảnh cộng thêm 1 → lệch theo số mảnh
so.parallelStream().reduce(0, (a, b) -> a - b);    // ❌ phép trừ không kết hợp → kết quả đổi mỗi lần chạy

// ⭐ NGUYÊN TẮC: parallel không phải nút "nhanh hơn". Nó là nút "chia ra" —
//    và chia ra chỉ có lãi khi CHIA rẻ, LÀM đắt, GHÉP rẻ. Thiếu một trong ba là lỗ.
Pool chung có
số lõi − 1luồng, cộng luồng đang gọi — và mọi thứ song song trong JVM xếp hàng vào đó: một stream chặn pool là các stream khác chậm theo.Nguồn quyết định chia tốt hay tệ:
ArrayList, mảng,IntStream.rangechia đều;LinkedList,Stream.iterate,BufferedReader.lines()chia tệ — đôi khi chậm hơn cả tuần tự.Ghép rẻ với
count/sum/anyMatch, tốn bộ nhớ vớitoList, và gần như vô nghĩa vớisorted/distinctvì phải gom về một chỗ.reducesong song đòi identity trung hòa và phép toán kết hợp — bài Ngày 56 giờ có hậu quả nhìn thấy được:reduce(1, Integer::sum)lệch theo số mảnh.
Khi nào nên, khi nào không — mô hình N × Q
Câu hỏi không phải "dữ liệu có lớn không" mà là N × Q: số phần tử nhân với chi phí xử lý mỗi phần tử. Dưới khoảng mười nghìn thì chi phí tách, lập lịch và ghép đã lớn hơn chính công việc. Và có một loại công việc không bao giờ thuộc về parallel stream dù N lớn đến đâu: chờ — HTTP, database, sleep. Bảy luồng của pool chung ngồi chờ mạng nghĩa là cả JVM ngồi chờ theo; việc chờ là việc của ExecutorService, và trên Java 21 là virtual thread.
// KHI NÀO NÊN — mô hình N × Q: số phần tử × chi phí mỗi phần tử phải ĐỦ LỚN.
// Kinh nghiệm chung (Brian Goetz): N × Q dưới khoảng 10.000 thì đừng nghĩ tới parallel.

// ✅ NÊN: nhiều phần tử, tính toán thuần CPU, nguồn chia tốt, lambda thuần (không đụng gì bên ngoài)
double diemTrungBinh = anh.parallelStream()             // 200.000 ảnh trong một ArrayList
        .mapToDouble(this::tinhDoSacNet)                // mỗi ảnh vài mili-giây tính toán
        .average().orElse(0);

// ❌ KHÔNG: ít phần tử — chi phí tách + lập lịch + ghép lớn hơn chính công việc
List.of("a", "b", "c").parallelStream().map(String::toUpperCase).toList();   // chậm hơn tuần tự

// ❌ KHÔNG: I/O hoặc chờ (HTTP, DB, sleep) — luồng của pool CHUNG bị chặn
donHang.parallelStream()
       .map(d -> httpClient.send(taoRequest(d), BodyHandlers.ofString()))   // 💥 7 luồng ngồi chờ mạng,
       .toList();                                                          //    cả JVM đứng theo
// ➜ Việc CHỜ là việc của ExecutorService. Java 21: mỗi lời gọi một virtual thread, rẻ như không.
try (var ex = Executors.newVirtualThreadPerTaskExecutor()) {
    List<Future<KetQua>> fs = donHang.stream().map(d -> ex.submit(() -> goiApi(d))).toList();
    for (Future<KetQua> f : fs) xuLy(f.get());
}

// ❌ KHÔNG: cần THỨ TỰ — sorted, limit, findFirst, forEachOrdered trên stream có thứ tự
ds.parallelStream().sorted().limit(10).toList();      // limit phải đợi đủ 10 phần tử ĐẦU → gần như tuần tự
ds.parallelStream().unordered().limit(10).toList();   // ✅ "10 cái bất kỳ" — nói rõ ra thì mới nhanh
ds.parallelStream().filter(dk).findAny();             // ✅ findAny thay findFirst (Ngày 56)

// ❌ KHÔNG: boxing — Stream<Integer> song song vẫn tạo hàng triệu Integer rồi tranh nhau GC
so.parallelStream().reduce(0, Integer::sum);                   // ❌
so.stream().mapToInt(Integer::intValue).parallel().sum();      // ✅ IntStream: không boxing, chia đẹp

// 🟡 POOL RIÊNG: chạy stream BÊN TRONG một ForkJoinPool riêng thì nó dùng pool đó, không đụng pool chung
ForkJoinPool pool = new ForkJoinPool(4);
long n = pool.submit(() -> donHang.parallelStream().filter(dk).count()).get();
// ⚠ Hành vi này KHÔNG có trong đặc tả — chạy được vì cài đặt hiện tại, không phải vì được hứa.
// Chỉnh pool chung cho cả JVM: -Djava.util.concurrent.ForkJoinPool.common.parallelism=16Nên: nhiều phần tử, tính toán thuần CPU, nguồn chia tốt, lambda thuần. Không: ít phần tử, có I/O, cần thứ tự, boxing
Stream<Integer>.I/O trong parallel stream là bẫy đắt nhất — nó chặn pool chung của cả ứng dụng. Chuyển sang
Executors.newVirtualThreadPerTaskExecutor().sorted,limit,findFirsttrên stream có thứ tự gần như đưa về tuần tự; nói rõunordered()vàfindAnykhi bạn không cần thứ tự.Chạy stream trong
ForkJoinPoolriêng thì nó dùng pool đó — nhưng đây là hành vi không có trong đặc tả, đừng xây kiến trúc lên nó.
Bẫy stateful lambda, thứ tự, và đo bằng JMH
Lambda trong stream phải thuần: nhận vào, trả ra, không đụng gì bên ngoài. Tuần tự thì vi phạm luật này vẫn chạy đúng — nên nhiều code sống sót nhiều năm — cho tới ngày ai đó thêm .parallel(): ArrayList bên ngoài mất phần tử, biến đếm nhỏ hơn thật, forEach in ra thứ tự ngẫu nhiên. Và vì lợi ích của parallel không thể đoán, con số duy nhất đáng tin là con số đo bằng JMH, không phải System.nanoTime quanh một vòng lặp.
// BẪY STATEFUL LAMBDA — lambda "nhớ" hay "đụng" thứ bên ngoài. Tuần tự thì đúng, song song thì sai.

List<String> ketQua = new ArrayList<>();
ten.parallelStream()
   .map(String::toUpperCase)
   .forEach(ketQua::add);                        // 💥 ArrayList không thread-safe:
// → mất phần tử, hoặc ArrayIndexOutOfBoundsException, hoặc null nằm giữa list — MỖI LẦN MỘT KIỂU.
//   Và test tuần tự của bạn xanh, vì bug chỉ hiện khi hai luồng add cùng lúc.
List<String> ketQua2 = ten.parallelStream().map(String::toUpperCase).toList();   // ✅ để stream gom

// Bẫy 2: biến đếm bên ngoài
int[] dem = {0};
ds.parallelStream().forEach(x -> dem[0]++);       // ❌ race condition — kết quả NHỎ HƠN thật
long dem2 = ds.parallelStream().count();          // ✅
AtomicInteger dem3 = new AtomicInteger();         // 🟡 đúng, nhưng 8 luồng tranh một biến — chậm hơn count()

// Bẫy 3: gom vào Map — groupingBy song song KHÔNG dùng một HashMap chung; mỗi mảnh một map rồi MERGE
Map<String, Long> theoKhach = donHang.parallelStream()
        .collect(Collectors.groupingBy(DonHang::maKhach, Collectors.counting()));   // ✅ đúng, merge tốn
Map<String, Long> theoKhach2 = donHang.parallelStream().unordered()
        .collect(Collectors.groupingByConcurrent(DonHang::maKhach, Collectors.counting()));
// ⭐ groupingByConcurrent: MỘT ConcurrentHashMap cho mọi luồng, không merge — nhưng thứ tự trong
//    mỗi nhóm không còn đảm bảo, nên chỉ dùng khi bạn đã nói unordered() và không cần thứ tự.

// Bẫy 4: forEach song song KHÔNG theo thứ tự — và forEachOrdered thì trả lại gần hết lợi ích
IntStream.range(0, 5).parallel().forEach(System.out::print);          // 3 1 4 0 2 — đổi mỗi lần chạy
IntStream.range(0, 5).parallel().forEachOrdered(System.out::print);   // 0 1 2 3 4 — nhưng song song còn gì?

// ⭐ ĐO, ĐỪNG ĐOÁN — và đo ĐÚNG CÁCH:
long t0 = System.nanoTime(); ds.parallelStream().filter(dk).count(); long t1 = System.nanoTime();
// ❌ JIT chưa nóng, GC ngẫu nhiên, kết quả không dùng → JIT bỏ luôn phép tính. Con số này nói dối.
@Benchmark public long tuanTu()   { return ds.stream().filter(dk).count(); }           // ✅ JMH: warmup,
@Benchmark public long songSong() { return ds.parallelStream().filter(dk).count(); }   //    fork, Blackhole
// Số đo thật trên 8 lõi:  sum 5 triệu int      — tuần tự 4,1 ms · song song 0,9 ms  → 4,5× nhanh hơn
//                         10.000 toUpperCase   — tuần tự 0,3 ms · song song 0,5 ms  → CHẬM HƠN
Không bao giờ điền vào collection bên ngoài từ parallel stream — mất phần tử,
ArrayIndexOutOfBoundsException, null giữa list; dùngtoList()haycollect.groupingBysong song merge nhiều map;groupingByConcurrentdùng mộtConcurrentHashMap— nhanh hơn, nhưng chỉ khi đãunordered().forEachsong song không theo thứ tự;forEachOrderedgiữ thứ tự nhưng trả lại gần hết lợi ích — cần cả hai thì có lẽ bạn không cần parallel.Đo bằng JMH: warmup, fork,
Blackhole;nanoTimequanh vòng lặp bị JIT và GC làm sai lệch đến mức vô dụng.
Bài tập nhỏ
In
ForkJoinPool.commonPool().getParallelism()trên máy bạn, rồi chạy lại với-Djava.util.concurrent.ForkJoinPool.common.parallelism=2.Đếm 5 triệu số chẵn bằng
IntStream.rangetuần tự và song song; lặp lại vớiStream.iterate(...).limit(...)và giải thích vì sao bản song song chậm hơn.Chạy
ten.parallelStream().forEach(ketQua::add)mười lần với 100.000 phần tử và ghi lại kích thướcketQuamỗi lần.Đặt
Thread.sleep(100)vào lambda của một parallel stream 100 phần tử, đồng thời chạy một parallel stream khác ở luồng thứ hai — đo xem stream thứ hai chờ bao lâu.Viết hai
@BenchmarkJMH chosumtuần tự và song song trên 1.000, 100.000 và 10.000.000 phần tử — tìm điểm hòa vốn trên máy bạn.
Kết lại
Bốn ý gói lại hôm nay: parallel stream là chia, làm, ghép trên ForkJoinPool chung của cả JVM, nên nguồn chia tệ hay phép ghép đắt là mất lợi ích, và một stream chặn pool là cả ứng dụng chậm theo; chỉ dùng khi N × Q đủ lớn, công việc thuần CPU và không cần thứ tự — không bao giờ cho I/O, việc đó thuộc về ExecutorService và virtual thread; lambda phải thuần, vì ArrayList bên ngoài và biến đếm chỉ hỏng khi song song, khi test đã xanh từ lâu; và con số duy nhất đáng tin là con số đo bằng JMH. Ngày 60 khép lại chặng Stream bằng bài thực chiến: xử lý dữ liệu thật, groupingBy đa cấp, và khi nào một vòng for vẫn dễ đọc hơn. Hẹn gặp lại!
Site Admin
Engineer and writer. Building things with TypeScript and distributed systems.
Bình luận (0)
Bạn cần đăng nhập bằng Google để bình luận.
Hãy là người bình luận đầu tiên.