Kafka trong dự án thực tế: đồng bộ PostgreSQL sang Elasticsearch bằng Debezium CDC
Dành cho Backend Developer đã biết producer, consumer, partition và offset. Đây là bài chuyên sâu bổ sung cho khóa Kafka 14 buổi, dùng làm tài liệu gốc để chuẩn bị video. Case study và số liệu do tác giả xây dựng để phân tích thiết kế, không phải báo cáo triển khai hay benchmark của một doanh nghiệp. Đối chiếu tài liệu ngày 30/10/2026.
1. Chủ đề này bổ sung gì cho khóa học?
Đối chiếu README khóa Kafka, kịch bản 14 buổi và các demo hiện có:
Nội dung: Producer, consumer, partition, offset. Khóa hiện tại: Buổi 2–8. Phạm vi bài này: Kiến thức đầu vào, chỉ nhắc khi cần
Nội dung: Retry và DLT. Khóa hiện tại: Buổi 9. Phạm vi bài này: Áp dụng vào lỗi mapping và phục hồi search
Nội dung: Testing. Khóa hiện tại: Buổi 10. Phạm vi bài này: Lập ma trận kiểm chứng khi quay demo
Nội dung: Idempotency, transaction, Outbox. Khóa hiện tại: Buổi 11, demo H2/JPA. Phạm vi bài này: Phân biệt với CDC bảng nghiệp vụ
Nội dung: Kafka Streams. Khóa hiện tại: Buổi 13. Phạm vi bài này: Chỉ ra khi nào cần projection có join
Nội dung: Kafka Connect và CDC PostgreSQL. Khóa hiện tại: Chưa có buổi/demo riêng; Connect được nêu ở hướng học tiếp cuối buổi 14. Phạm vi bài này: Nội dung chính
Nội dung: Snapshot, replication slot, WAL và mất vị trí đọc. Khóa hiện tại: Chưa có phần triển khai riêng. Phạm vi bài này: Nội dung chính
Nội dung: Elasticsearch sink, delete, dựng index mới và chuyển alias. Khóa hiện tại: Chưa có phần triển khai riêng. Phạm vi bài này: Nội dung chính
Khảo sát này nói về tài liệu và demo trong repository, không khẳng định đã xem mọi video từng đăng. Bài SSE/WebSocket/Polling có nhắc CDC ở luồng thông báo nhưng chưa triển khai pipeline search.
Các chủ đề tiếp nối khác đáng làm là Schema Registry/Avro khi nhiều team đổi event schema, Saga cho quy trình đặt hàng, và vận hành Kafka theo SLO. Bài này chọn CDC vì có một bài toán nhìn thấy được trên màn hình, có lỗi để tái hiện, và nối trực tiếp nền tảng Kafka với một hệ thống phục vụ người dùng.
2. Bài toán: sản phẩm đã đổi giá, tìm kiếm vẫn trả giá cũ
Giả sử ta xây catalog cho một sàn thương mại điện tử. PostgreSQL lưu sản phẩm và là nguồn dữ liệu chuẩn. Elasticsearch phục vụ tìm kiếm theo tên, lọc khoảng giá, trạng thái bán và thương hiệu.
Một nhân viên đổi giá sản phẩm 1001 từ 890.000 thành 790.000 đồng. Trang quản trị thông báo thành công nhưng trang tìm kiếm vẫn hiện 890.000 đồng. Câu hỏi cần trả lời không chỉ là “gửi message thế nào”, mà gồm:
DB commit rồi ứng dụng chết thì ai cập nhật search?
Elasticsearch ngừng hoạt động hai giờ thì dữ liệu chờ ở đâu?
Sản phẩm bị xóa thì document trong search có biến mất không?
Replay message có làm giá quay về giá cũ không?
Đổi analyzer hoặc mapping phải dựng lại toàn bộ index bằng cách nào?
2.1. Yêu cầu thiết kế giả định
Thuộc tính: Quy mô. Giả định cho case study: 2 triệu sản phẩm, 100 thay đổi/giây trung bình, có burst
Thuộc tính: Freshness. Giả định cho case study: Mục tiêu p95 từ DB commit đến kết quả tìm kiếm dưới 3 giây khi hệ thống bình thường
Thuộc tính: Gián đoạn đích. Giả định cho case study: Muốn chịu Elasticsearch ngừng 2 giờ và sau đó bắt kịp
Thuộc tính: Nghiệp vụ. Giả định cho case study: Checkout luôn xác minh giá/tồn kho với hệ thống nghiệp vụ
Thuộc tính: Tính nhất quán. Giả định cho case study: Search chấp nhận eventual consistency; không dùng search để quyết định trừ tiền
Thuộc tính: Khả năng phục hồi. Giả định cho case study: Dựng index mới, đối soát, chuyển alias và có đường rollback
Các con số trên là đầu vào để tính và kiểm thử. Chưa đo thì không thể tuyên bố đạt SLO.
2.2. Vì sao hai lời gọi liên tiếp chưa giải quyết được?
// Minh họa cửa sổ lỗi, không phải giải pháp production.
productService.updatePriceInDatabase(1001L, 790_000L);
searchClient.indexProduct(1001L);
Nếu lời gọi thứ nhất commit rồi process bị kill, lời gọi thứ hai không xảy ra. Đảo thứ tự lại có thể tạo dữ liệu search cho một transaction DB cuối cùng rollback. Thêm retry trong RAM không cứu được khi cả process mất.
Với catalog nhỏ, PostgreSQL full-text search hoặc một job đồng bộ định kỳ có đối soát có thể đủ tốt. CDC trở nên đáng cân nhắc khi đã có nhu cầu search riêng, nhiều đường ghi DB và yêu cầu phục hồi có kiểm soát. Kafka làm tăng chi phí vận hành; “có Kafka” tự nó không phải một yêu cầu nghiệp vụ.
3. Kiến trúc: DB lưu sự thật, Kafka giữ thay đổi, Elasticsearch phục vụ đọc
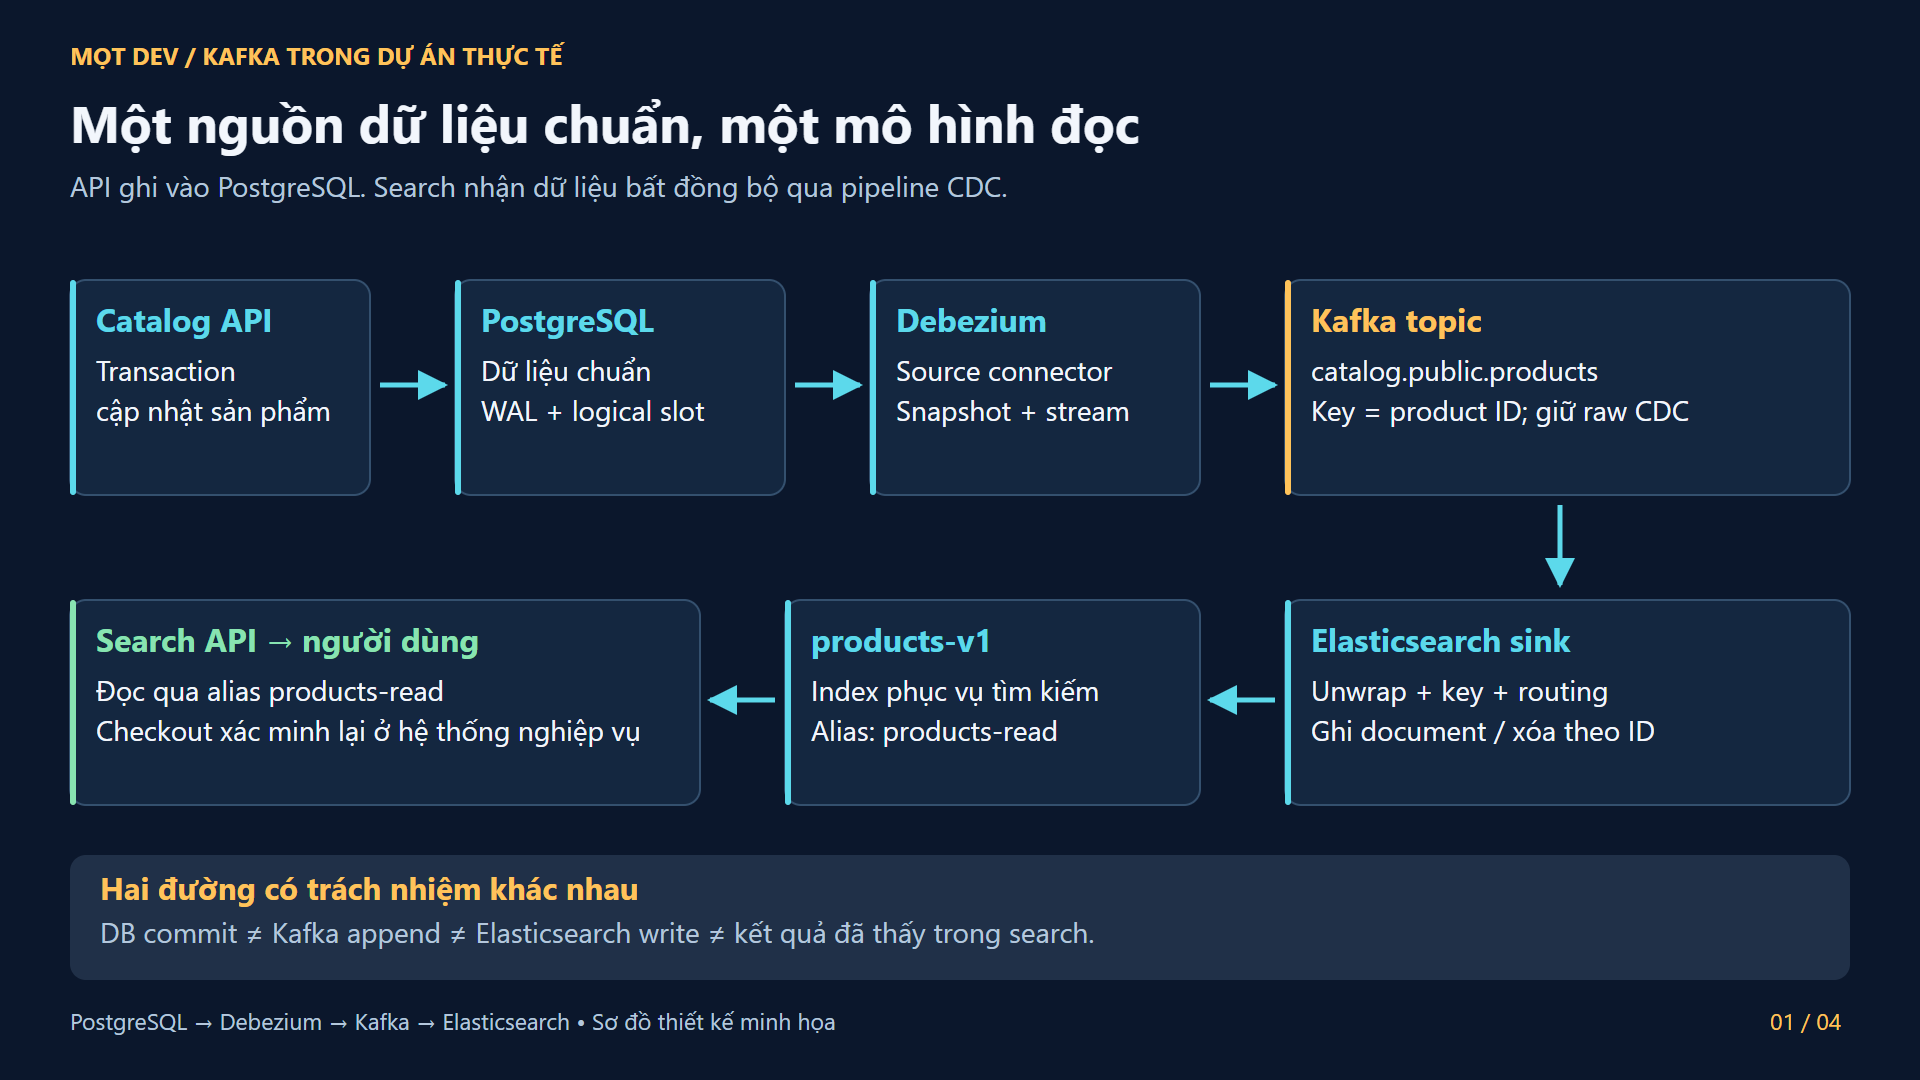
Mở sơ đồ kích thước đầy đủ: Kiến trúc CDC và hai đường đọc ghi
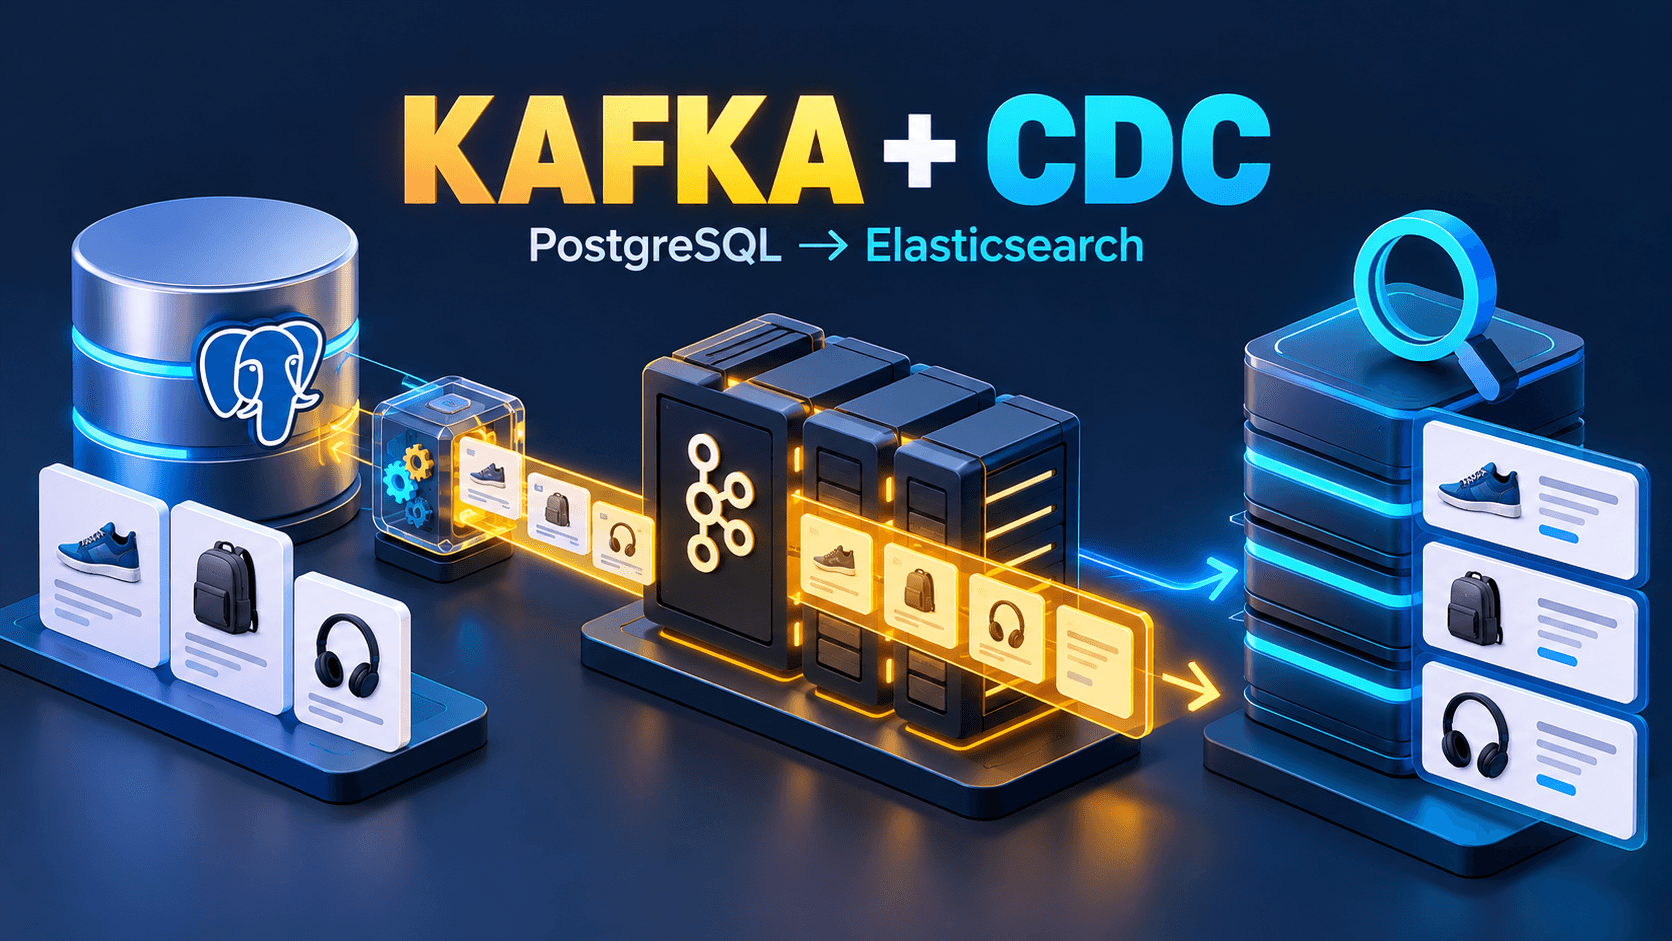
Luồng được chọn:
Admin gọi Catalog API. API cập nhật PostgreSQL trong transaction bình thường.
PostgreSQL ghi WAL — write-ahead log, nhật ký phục hồi của database.
Debezium đọc thay đổi qua logical replication rồi phát CDC record lên Kafka.
Elasticsearch sink đọc record, biến đổi thành document và gửi vào index.
Search API truy vấn alias
products-read; checkout vẫn xác minh từ hệ thống nghiệp vụ.
CDC là Change Data Capture: thu nhận thay đổi dữ liệu. Logical decoding diễn giải thay đổi trong WAL thành dạng downstream đọc được. Replication slot giữ vị trí mà bên đọc còn cần; nó không phải một bảng queue do ứng dụng tự tạo. Xem PostgreSQL 17: Logical Decoding Concepts.
3.1. Kafka Connect làm phần nào?
Kafka Connect là runtime chạy connector. Source connector đưa dữ liệu vào Kafka; sink connector đưa dữ liệu ra hệ thống đích. Worker chạy task, quản lý lifecycle và trạng thái; converter xử lý dạng serialization; SMT — Single Message Transform — biến đổi từng record. Distributed mode lưu cấu hình, offset nguồn và trạng thái trong các internal topic. Đây là các vai trò của Kafka Connect.
Trong case study, nên tách source và sink thành deployment riêng khi yêu cầu vận hành tăng: lỗi thư viện Elasticsearch không cần kéo theo worker đọc PostgreSQL. Cái giá là thêm cấu hình, quan sát và tài nguyên. Lab có thể dùng chung worker, nhưng phải có đầy đủ plugin của cả hai phía.
3.2. CDC bảng nghiệp vụ khác domain event
products.price_vnd đổi từ A sang B chỉ nói một row đã đổi. Nó không tự giải thích đó là khuyến mại, sửa lỗi nhập liệu hay điều chỉnh theo hợp đồng.
Nhu cầu: Đồng bộ ảnh chụp hiện tại của sản phẩm sang search. Thiết kế phù hợp cho case này: CDC bảng
productsNhu cầu: Phát sự kiện
OrderApprovedvới ý nghĩa nghiệp vụ ổn định. Thiết kế phù hợp cho case này: Domain event + Transactional OutboxNhu cầu: Một document cần join sản phẩm, thương hiệu, khuyến mại. Thiết kế phù hợp cho case này: Projection có state/join, không chỉ unwrap CDC
Nhu cầu: Gửi email hoặc thu tiền đúng một lần theo nghiệp vụ. Thiết kế phù hợp cho case này: State machine + idempotency của side effect
CDC và Outbox kết hợp được: Debezium đọc bảng outbox thay cho relay polling. Outbox Event Router hỗ trợ định tuyến event theo cấu trúc outbox. Đó là hướng khác với việc coi mọi thay đổi row là public API của microservice.
4. Chọn hợp đồng dữ liệu trước khi viết cấu hình
Ta giới hạn bài toán vào một document tương ứng một row. Dùng ID bền vững, không tái sử dụng ID sản phẩm đã xóa. Đơn vị tiền là đồng Việt Nam nguyên, không dùng số thực cho giá.
CREATE TABLE public.products (
    id          bigint PRIMARY KEY,
    name        varchar(160) NOT NULL,
    brand       varchar(80) NOT NULL,
    price_vnd   bigint NOT NULL CHECK (price_vnd >= 0),
    active      boolean NOT NULL DEFAULT true,
    updated_at  timestamptz NOT NULL DEFAULT now()
);

INSERT INTO public.products (id, name, brand, price_vnd)
VALUES (1001, 'Bàn phím cơ K1', 'MotDev Lab', 890000);

UPDATE public.products
SET price_vnd = 790000, updated_at = now()
WHERE id = 1001;
DEFAULT now() chỉ cấp giá trị khi insert thiếu trường; nó không tự cập nhật updated_at cho mọi câu UPDATE. Tất cả đường ghi phải cập nhật trường này, hoặc dùng trigger được thiết kế và kiểm chứng riêng. Freshness từ updated_at vì vậy chỉ là proxy nếu chưa có hợp đồng rõ.
Case này cố ý dùng các trường ngắn và đầy đủ trong mỗi document. Thêm dữ liệu lớn có TOAST, generated columns, bảng partitioned hoặc một document join nhiều bảng cần phân tích CDC riêng; không mở rộng ví dụ bằng cách thêm một field rồi mặc định mọi snapshot/update đều chứa đủ payload.
4.1. Ba loại “vị trí” không được trộn lẫn
Vị trí: PostgreSQL LSN. Ý nghĩa trong pipeline: Vị trí trong transaction log. Không chứng minh được: Một offset Kafka toàn cục
Vị trí: Kafka
(topic, partition, offset). Ý nghĩa trong pipeline: Vị trí record trong một partition. Không chứng minh được: Thứ tự giữa các partitionVị trí: Sink committed offset. Ý nghĩa trong pipeline: Vị trí consumer đã checkpoint theo cơ chế sink. Không chứng minh được: Kết quả đã xuất hiện trong search query
Một transaction DB có thể đổi nhiều row. Không lấy LSN rồi mặc định đó là sequence duy nhất cho mọi event nghiệp vụ. Tương tự, offset 900 ở partition 0 không “mới hơn” offset 800 ở partition 2.
5. Snapshot ban đầu: lấy dữ liệu cũ mà vẫn theo kịp dữ liệu mới
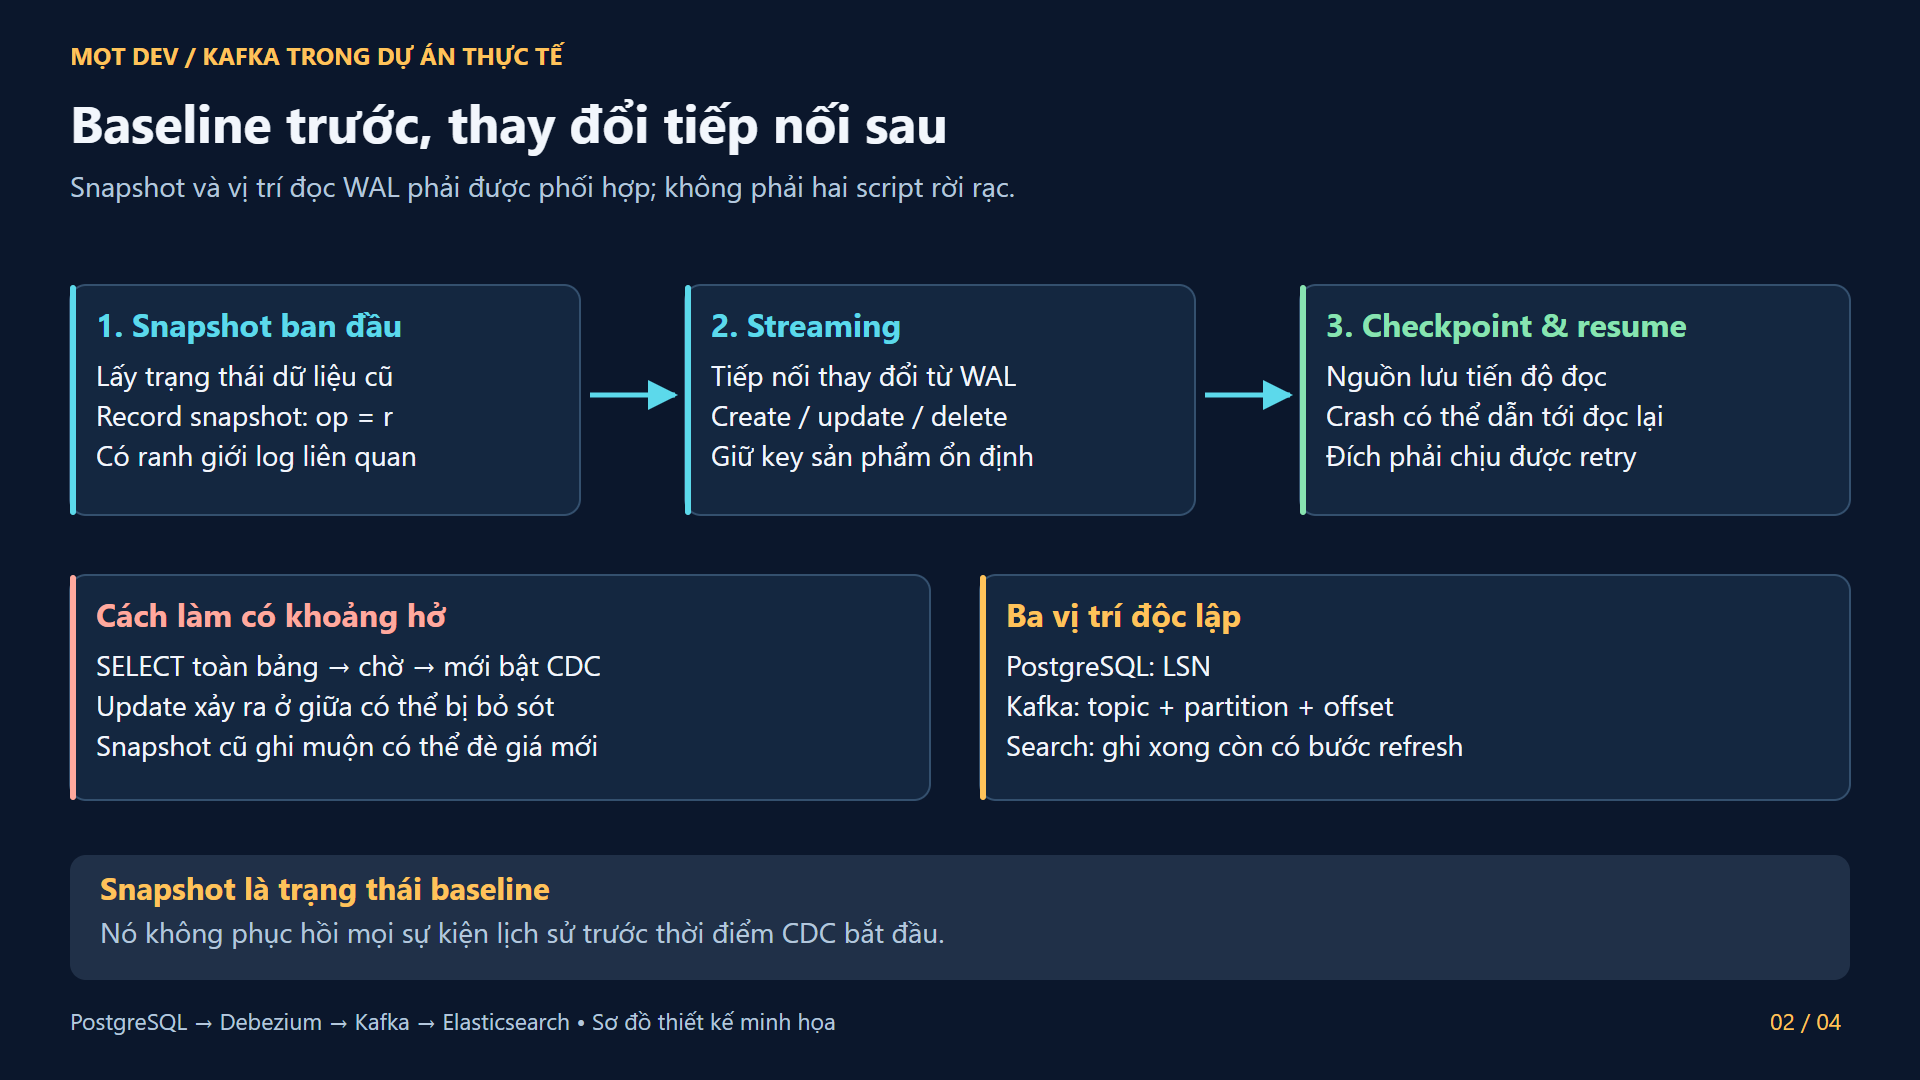
Mở sơ đồ kích thước đầy đủ: Snapshot, streaming và checkpoint
Khi thêm CDC vào một hệ thống đã có 2 triệu sản phẩm, chỉ đọc thay đổi tương lai sẽ bỏ sót sản phẩm chưa từng được sửa. Ta cần baseline rồi theo dõi thay đổi tiếp.
Debezium PostgreSQL với snapshot.mode=initial thực hiện snapshot ban đầu khi chưa có offset phù hợp, sau đó streaming từ vị trí liên quan đến snapshot. Connector này dùng một task; tăng tasks.max không chia một PostgreSQL source thành nhiều task đọc song song. Chi tiết snapshot và envelope nằm trong Debezium PostgreSQL connector 3.3.
Thiết kế của bài giữ raw CDC trong Kafka. Một record có key chứa ID; value chứa trạng thái trước/sau và metadata. Payload dưới đây là minh họa rút gọn, bỏ wrapper schema và nhiều metadata:
{
  "key": { "id": 1001 },
  "value": {
    "before": null,
    "after": {
      "id": 1001,
      "name": "Bàn phím cơ K1",
      "brand": "MotDev Lab",
      "price_vnd": 790000,
      "active": true,
      "updated_at": "2026-10-30T08:00:00Z"
    },
    "op": "r"
  }
}
r biểu diễn record snapshot; c, u, d lần lượt là create, update, delete. Snapshot là trạng thái tại baseline, không tái tạo được mọi thay đổi lịch sử trước khi CDC bắt đầu.
5.1. Race condition khi tự làm bootstrap
Một cách dễ sai là chạy SELECT * FROM products, đợi export xong rồi mới bật CDC. Sản phẩm đổi trong khoảng giữa hai bước có thể không nằm trong baseline và cũng không xuất hiện ở phần stream mà ta đọc.
Một cách khác cũng sai là nạp snapshot cũ và stream mới song song vào cùng index mà không có quy tắc version: snapshot 890.000 đồng đến sau event 790.000 đồng sẽ ghi đè giá mới.
Vì thế, baseline, vị trí bắt đầu stream và quy tắc áp dụng phải là một protocol thống nhất. Khi quay video, vẽ chính khoảng hở này trước khi giới thiệu connector; người xem sẽ hiểu vì sao “đọc DB rồi gửi Kafka” chưa đủ.
6. Cấu hình tham chiếu: PostgreSQL → Kafka
Phần này là cấu hình để chuẩn bị lab, chưa phải một bộ Docker Compose đã chạy end-to-end. Tài liệu source/SMT dùng Debezium 3.3; ví dụ sink theo Confluent Elasticsearch self-managed dòng 16.x, Elasticsearch 8.19.x. Đây là các dòng API tham chiếu, không phải tuyên bố mọi tổ hợp bản vá tương thích. Trước khi quay cần chốt bản vá/image digest, Java runtime, plugin và kiểm thử bằng ma trận ở phần 14. Tài liệu sink mô tả tương thích và thay đổi client ở dòng 16.
6.1. Điều kiện hạ tầng
PostgreSQL cần wal_level=logical, đủ max_replication_slots và max_wal_senders; tài khoản CDC có LOGIN/REPLICATION, quyền CONNECT database, USAGE schema và SELECT bảng snapshot. DBA tạo publication cho đúng bảng, kiểm tra quyền và cấu hình logical replication của dịch vụ managed. Ví dụ publication do DBA chạy trong database catalog:
CREATE PUBLICATION catalog_products_pub FOR TABLE public.products;Không cấp superuser cho connector để né lỗi quyền. Không dùng FOR ALL TABLES nếu chỉ cần catalog. Các setting và giới hạn slot được mô tả ở PostgreSQL 17: Replication.
Tạo topic catalog.public.products trước với số partition đã tính theo tải và một kế hoạch migration nếu sau này thay đổi. Lab có thể dùng một partition để quan sát thứ tự. Production cần replication factor/min ISR, retention, dung lượng và ACL phù hợp; đừng sao chép cấu hình single broker của bài demo sang production.
6.2. JSON cấu hình source
Đây là body cho PUT /connectors/catalog-products-source/config:
{
  "connector.class": "io.debezium.connector.postgresql.PostgresConnector",
  "tasks.max": "1",
  "database.hostname": "postgres",
  "database.port": "5432",
  "database.user": "cdc_catalog",
  "database.password": "${file:/run/secrets/catalog.properties:password}",
  "database.dbname": "catalog",
  "topic.prefix": "catalog",
  "plugin.name": "pgoutput",
  "slot.name": "catalog_products_slot",
  "publication.name": "catalog_products_pub",
  "publication.autocreate.mode": "disabled",
  "table.include.list": "public.products",
  "snapshot.mode": "initial",
  "tombstones.on.delete": "true",
  "key.converter": "org.apache.kafka.connect.json.JsonConverter",
  "key.converter.schemas.enable": "true",
  "value.converter": "org.apache.kafka.connect.json.JsonConverter",
  "value.converter.schemas.enable": "true"
}
Đường dẫn /run/secrets/... là đường dẫn trong container worker, không phải đường dẫn PowerShell trên host. Bật file provider trong cấu hình worker và mount file bí mật ngoài Git:
config.providers=file
config.providers.file.class=org.apache.kafka.common.config.provider.FileConfigProvider
Không đưa mật khẩu thật vào JSON bài viết. Trong production còn cần TLS và cấu hình xác thực của Kafka/PostgreSQL.
Giữ nguyên connector identity, slot, topic prefix và internal offset topic khi restart thông thường. Đổi tên để “chạy lại cho sạch” có thể khởi động một lịch sử khác; đó là một migration cần kế hoạch, không phải cách sửa lỗi mặc định.
7. Kafka → Elasticsearch: document ID, mapping và delete
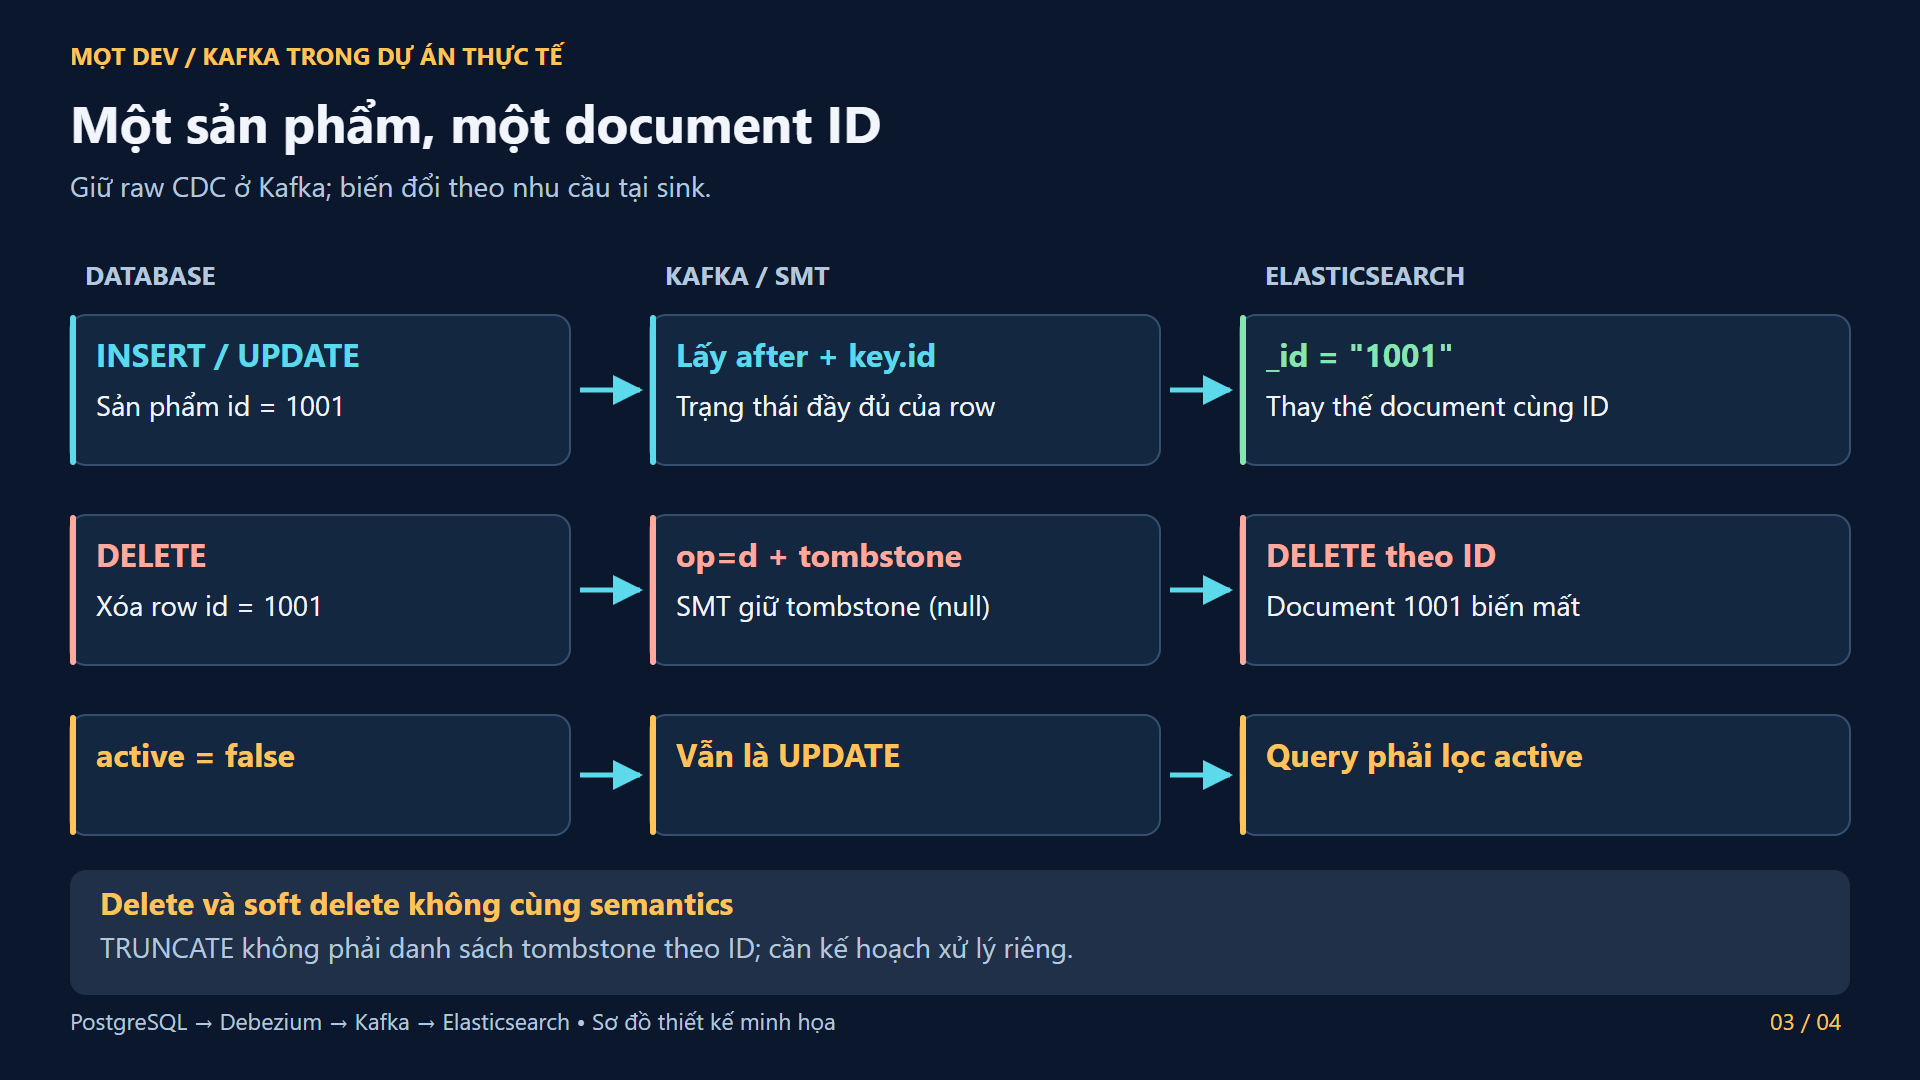
Mở sơ đồ kích thước đầy đủ: Luồng create, update và delete
7.1. Một sản phẩm phải giữ một document ID
Trong thiết kế này, key id=1001 trở thành _id="1001". Một update thay thế document cùng ID. Nếu sinh ID mới theo từng message, index sẽ chứa nhiều bản của cùng sản phẩm.
Tạo index trước để kiểm soát mapping; ví dụ sau là JSON body cho PUT /products-v1:
{
  "aliases": { "products-read": {} },
  "mappings": {
    "dynamic": "strict",
    "properties": {
      "id":         { "type": "long" },
      "name":       { "type": "text" },
      "brand":      { "type": "keyword" },
      "price_vnd":  { "type": "long" },
      "active":     { "type": "boolean" },
      "updated_at": { "type": "date" }
    }
  }
}
name: text ở đây là điểm bắt đầu cho lab, chưa phải một giải pháp tìm kiếm tiếng Việt đã tối ưu. Chọn analyzer, chuẩn hóa dấu và relevance phải có bộ query mẫu và đánh giá riêng. dynamic: strict giúp lỗi thêm field bộc lộ sớm, đổi lại một schema rollout không phối hợp có thể dừng sink.
7.2. Biến đổi ở sink, giữ raw event ở topic
Source không unwrap. Sink mới lấy after, trích field id của key và đổi topic đích thành tên index. Nhờ đó, một consumer khác vẫn đọc được raw envelope để xử lý theo cách riêng.
Đối với delete, Debezium có record op=d rồi tombstone có value null. SMT được chọn giữ tombstone cho sink xóa document. rewrite tạo payload đánh dấu __deleted; không tự đồng nghĩa với xóa document trong Elasticsearch. Xem ExtractNewRecordState 3.3.
Body tham chiếu cho PUT /connectors/catalog-search-v1/config:
{
  "connector.class": "io.confluent.connect.elasticsearch.ElasticsearchSinkConnector",
  "tasks.max": "1",
  "topics": "catalog.public.products",
  "connection.url": "http://elasticsearch:9200",
  "key.converter": "org.apache.kafka.connect.json.JsonConverter",
  "key.converter.schemas.enable": "true",
  "value.converter": "org.apache.kafka.connect.json.JsonConverter",
  "value.converter.schemas.enable": "true",
  "key.ignore": "false",
  "schema.ignore": "true",
  "write.method": "INSERT",
  "behavior.on.null.values": "DELETE",
  "behavior.on.malformed.documents": "FAIL",
  "errors.tolerance": "none",
  "max.in.flight.requests": "1",
  "flush.synchronously": "true",
  "transforms": "unwrap,key,route",
  "transforms.unwrap.type": "io.debezium.transforms.ExtractNewRecordState",
  "transforms.unwrap.delete.tombstone.handling.mode": "tombstone",
  "transforms.key.type": "org.apache.kafka.connect.transforms.ExtractField$Key",
  "transforms.key.field": "id",
  "transforms.route.type": "org.apache.kafka.connect.transforms.RegexRouter",
  "transforms.route.regex": "catalog\\.public\\.products",
  "transforms.route.replacement": "products-v1"
}
HTTP không xác thực trong ví dụ chỉ dành cho mạng lab cô lập. Production dùng HTTPS/credential provider và quyền ghi đúng index. Plugin sink không có sẵn chỉ vì container chạy Kafka Connect; sink worker cũng cần Debezium SMT trong plugin path với classloading được kiểm tra. Cùng tên class không chứng minh plugin đã nạp: xem endpoint connector plugins và validate config trước.
Ở sink này, INSERT thay thế document cùng ID; UPSERT chỉ thêm/sửa field có mặt và có thể giữ field cũ. flush.synchronously=true cần khi SMT đổi tên topic. Với regular index, key ổn định và đường INSERT/DELETE, connector dùng external version từ offset; UPSERT có semantics khác. Đây là lý do phải đọc configuration reference của đúng sink, không bê cấu hình Confluent Cloud V2 sang self-managed.
7.3. Delete thật, soft delete và truncate là ba chuyện khác nhau
Nếu SQL là DELETE ... WHERE id=1001, ta mong _id=1001 biến mất. Nếu SQL là UPDATE ... SET active=false, đó vẫn là một update; document còn tồn tại. Search API phải luôn áp filter active=true, và không cho client tùy ý bỏ filter bắt buộc.
TRUNCATE không phải một chuỗi tombstone theo từng ID. Pipeline minh họa không hỗ trợ truncate như cách xóa catalog. Với thao tác bulk purge, chọn xóa theo khóa hoặc rebuild index có kế hoạch. Đổi primary key cũng phải được kiểm chứng như xóa khóa cũ và tạo khóa mới.
8. At-least-once, ordering và những giới hạn của “không trùng”
Giả sử sink gửi batch thành công nhưng chết trước checkpoint. Khi khởi động lại, các record có thể được đọc lại. Ghi cùng ID giúp không nhân đôi document, nhưng chỉ “cùng ID” chưa giải quyết mọi vấn đề thứ tự.
8.1. Quy tắc của case study
Một sản phẩm chỉ có một key chuẩn, serialization của key ổn định.
Mọi update của sản phẩm đi cùng partition trong một thế hệ topic.
Một pipeline được chỉ định ghi vào một thế hệ index.
Không đổi số partition hoặc topic nguồn rồi tiếp tục trộn offset version vào cùng index như chưa có gì xảy ra.
Rebuild dài ngày đi vào index rỗng mới; chỉ phục vụ người dùng sau khi bắt kịp và đối soát.
Kafka đảm bảo thứ tự trong partition, không phải thứ tự toàn hệ thống. Log compaction cũng không biến topic thành một audit log giữ mọi phiên bản. Các giới hạn nền tảng này được giải thích trong Kafka Design.
8.2. Vì sao replay vào index đang phục vụ có thể gây lỗi?
Hình dung giá cũ ở offset 20, giá mới ở offset 30. Nếu tự viết consumer chỉ gọi index theo ID, ghi offset 20 sau offset 30 có thể đưa giá quay lại. Dùng connector với cơ chế version phù hợp giúp xử lý đường update này, nhưng không nên suy rộng ra mọi đường ghi.
Đặc biệt, document đã xóa không giữ hàng rào version vô hạn. Nếu replay rất cũ vào một index đang sống sau khi metadata delete đã được dọn, có nguy cơ làm sống lại dữ liệu trong quá trình replay. Một luồng đầy đủ có thể xóa lại ở cuối, nhưng người dùng vẫn thấy trạng thái sai tạm thời; luồng thiếu delete thì sai vĩnh viễn. Case này tránh đường đó bằng index mới và đối soát trước chuyển alias. Cơ chế lưu version của delete và index.gc_deletes được mô tả trong Elasticsearch Delete API.
Tương tự, phát một payload cũ vào cuối topic tạo offset mới. Sink không biết nội dung đó cũ về nghiệp vụ. Sửa lỗi bằng cách lấy trạng thái chuẩn hiện tại hoặc dùng một protocol có business version, không đơn giản đẩy lại JSON cũ từ DLQ.
8.3. Không gọi toàn pipeline là một transaction
DB commit, Kafka append, Elasticsearch write và Elasticsearch refresh là các mốc khác nhau. Thành công ở mốc trước không chứng minh mốc sau hoàn thành. Search có thể chưa thấy document vừa index vì còn chờ refresh; xem Elasticsearch near-real-time search.
Với consumer tự viết dùng Bulk API, HTTP 200 của request không đủ: cần kiểm tra errors và từng item. Không checkpoint vượt qua một record chưa xử lý trong partition chỉ vì các record sau nó đã xong. Bulk API trả kết quả theo item chính vì một batch có thể thành công một phần.
9. Khi hệ thống hỏng: backlog nằm ở đâu?
Sự cố: Elasticsearch down. Nơi tích lại / dấu hiệu: Sink lag tăng; source có thể vẫn chạy. Cách xử lý cho case study: Khôi phục đích, restart task nếu đã FAILED sau hết retry, đo catch-up
Sự cố: Source/Connect down. Nơi tích lại / dấu hiệu: WAL cần cho slot có thể tăng. Cách xử lý cho case study: Khôi phục source trước khi hết ngân sách WAL/disk
Sự cố: Kafka không ghi được. Nơi tích lại / dấu hiệu: Source không hoàn tất phát/checkpoint; áp lực có thể dồn về PostgreSQL. Cách xử lý cho case study: Kiểm tra broker, quota, ISR, disk và WAL nguồn
Sự cố: Một record sai mapping. Nơi tích lại / dấu hiệu: Sink task lỗi hoặc error metric tăng. Cách xử lý cho case study: Sửa mapping/projection có kế hoạch rồi retry; không mặc định skip
Sự cố: WAL cần đọc đã mất. Nơi tích lại / dấu hiệu: Source không thể tiếp tục từ checkpoint cũ. Cách xử lý cho case study: Đánh giá mất khoảng nào, tạo baseline mới và đối soát
Sự cố: Delete không tới sink. Nơi tích lại / dấu hiệu: Sản phẩm ma trong search. Cách xử lý cho case study: Kiểm tra key, tombstone, SMT, retention và filter
9.1. WAL không phải ổ đĩa vô hạn
Replication slot bị bỏ quên có thể giữ lại WAL và làm tăng sử dụng disk. Giới hạn max_slot_wal_keep_size bảo vệ tài nguyên nhưng không bảo đảm giữ được khả năng resume nếu reader tụt quá xa. Giới hạn được thực thi theo cơ chế PostgreSQL, không phải một quota byte cứng tức thời. Đọc replication settings trước khi chốt ngân sách.
Query vận hành mẫu cho PostgreSQL 17:
SELECT slot_name,
       active,
       restart_lsn,
       confirmed_flush_lsn,
       wal_status,
       safe_wal_size,
       pg_size_pretty(
         pg_wal_lsn_diff(pg_current_wal_lsn(), restart_lsn)
       ) AS distance_from_restart
FROM pg_replication_slots
WHERE slot_name = 'catalog_products_slot';
distance_from_restart là khoảng cách LSN hữu ích để theo dõi, không phải tổng dung lượng filesystem chính xác. Theo dõi cả disk thực, tốc độ tăng, trạng thái slot và deadline xử lý. Ý nghĩa các cột có trong pg_replication_slots.
Không xóa slot đang dùng để làm disk đẹp trở lại rồi giả định connector tự nối tiếp. Nếu buộc phải bỏ slot, đó là thao tác chấp nhận thay đổi kế hoạch phục hồi, phải tạo baseline và kiểm chứng lại. Failover PostgreSQL cũng cần một kịch bản thử riêng cho phiên bản/dịch vụ sử dụng, không mặc định slot luôn có trên primary mới.
9.2. DLT giúp lưu lỗi, không làm search tự đúng
Giả sử update giá lỗi mapping rồi bị đưa sang DLT, còn các update sau được cho qua. Pipeline có thể “xanh”, lag thấp nhưng document vẫn sai. Với case này, cấu hình mẫu dừng khi lỗi; đó là lựa chọn ưu tiên correctness để dễ quan sát lúc học.
Ở production, cho phép cách ly lỗi cần owner, cảnh báo, thời hạn xử lý và cơ chế sửa trạng thái. Record lỗi phải giữ topic/partition/offset, key, schema và lý do lỗi trong phạm vi dữ liệu cho phép. Khi sửa, đối soát trạng thái hiện tại hoặc rebuild phạm vi ảnh hưởng; đừng republish payload cũ vô điều kiện. DLT có thể chứa dữ liệu nhạy cảm nên cần ACL và retention riêng.
10. Retention và capacity: tính từ khả năng khôi phục
Giả sử mỗi CDC record serialize trung bình 1,5 kB, tốc độ 100 record/giây. Dùng đơn vị thập phân để tránh nhầm:
100 × 1.500 byte = 150.000 byte/giây
150.000 × 86.400 = 12,96 GB/ngày logical payload
7 ngày × 12,96 GB × replication factor 3 = 272,16 GB
Đây chỉ là payload nhân replication, chưa có snapshot ban đầu, key/header, index/segment, compression, burst, rebalance hay headroom. Nếu bản snapshot trung bình cũng 1,5 kB, 2 triệu record thêm khoảng 3 GB logical payload. Phải đo kích thước thực; không lấy kích thước row DB làm kích thước CDC record.
Với source đều 100 record/giây, sink down hai giờ:
backlog = 100 × 7.200 = 720.000 record
sink sau khôi phục = 400 record/giây
tốc độ rút backlog = 400 - 100 = 300 record/giây
thời gian bắt kịp ≈ 720.000 / 300 = 2.400 giây = 40 phút
Nếu sink chỉ xử lý 100 record/giây thì backlog không giảm. Nếu input vẫn tăng trong lúc catch-up, thời gian thực còn dài hơn. Retention phải vượt thời gian phát hiện, khôi phục, bắt kịp và biên an toàn; không chỉ vượt hai giờ downtime.
10.1. Compaction không thay thế backup hoặc baseline
Topic cleanup.policy=delete giữ lịch sử theo giới hạn retention; sản phẩm không đổi lâu ngày có thể không còn record để dựng lại. compact hướng tới giữ trạng thái cuối theo key, không giữ mọi phiên bản; tombstone cũng có thời gian lưu. compact,delete áp dụng cả hai cơ chế, không có nghĩa “giữ trạng thái cuối mãi”. Tham số chính nằm trong Kafka Topic Configs.
Để rebuild vào index rỗng, record của một key đã xóa không còn tồn tại có thể là đúng: index mới cũng không có key đó. Nhưng nếu còn baseline cũ cần delete để loại key, hoặc đang replay vào index đã có dữ liệu, thiếu tombstone sẽ là vấn đề. Vì vậy phải chứng minh bộ dữ liệu đầu vào đủ cho trạng thái hiện tại, không chỉ nói “topic còn đọc được”.
WAL retention là ngân sách từ DB đến source; Kafka retention là ngân sách từ topic đến downstream. Hai ngân sách này độc lập. Tăng retention Kafka không cứu WAL đã mất trước khi source phát lên Kafka.
11. Dựng lại index không làm gián đoạn tìm kiếm
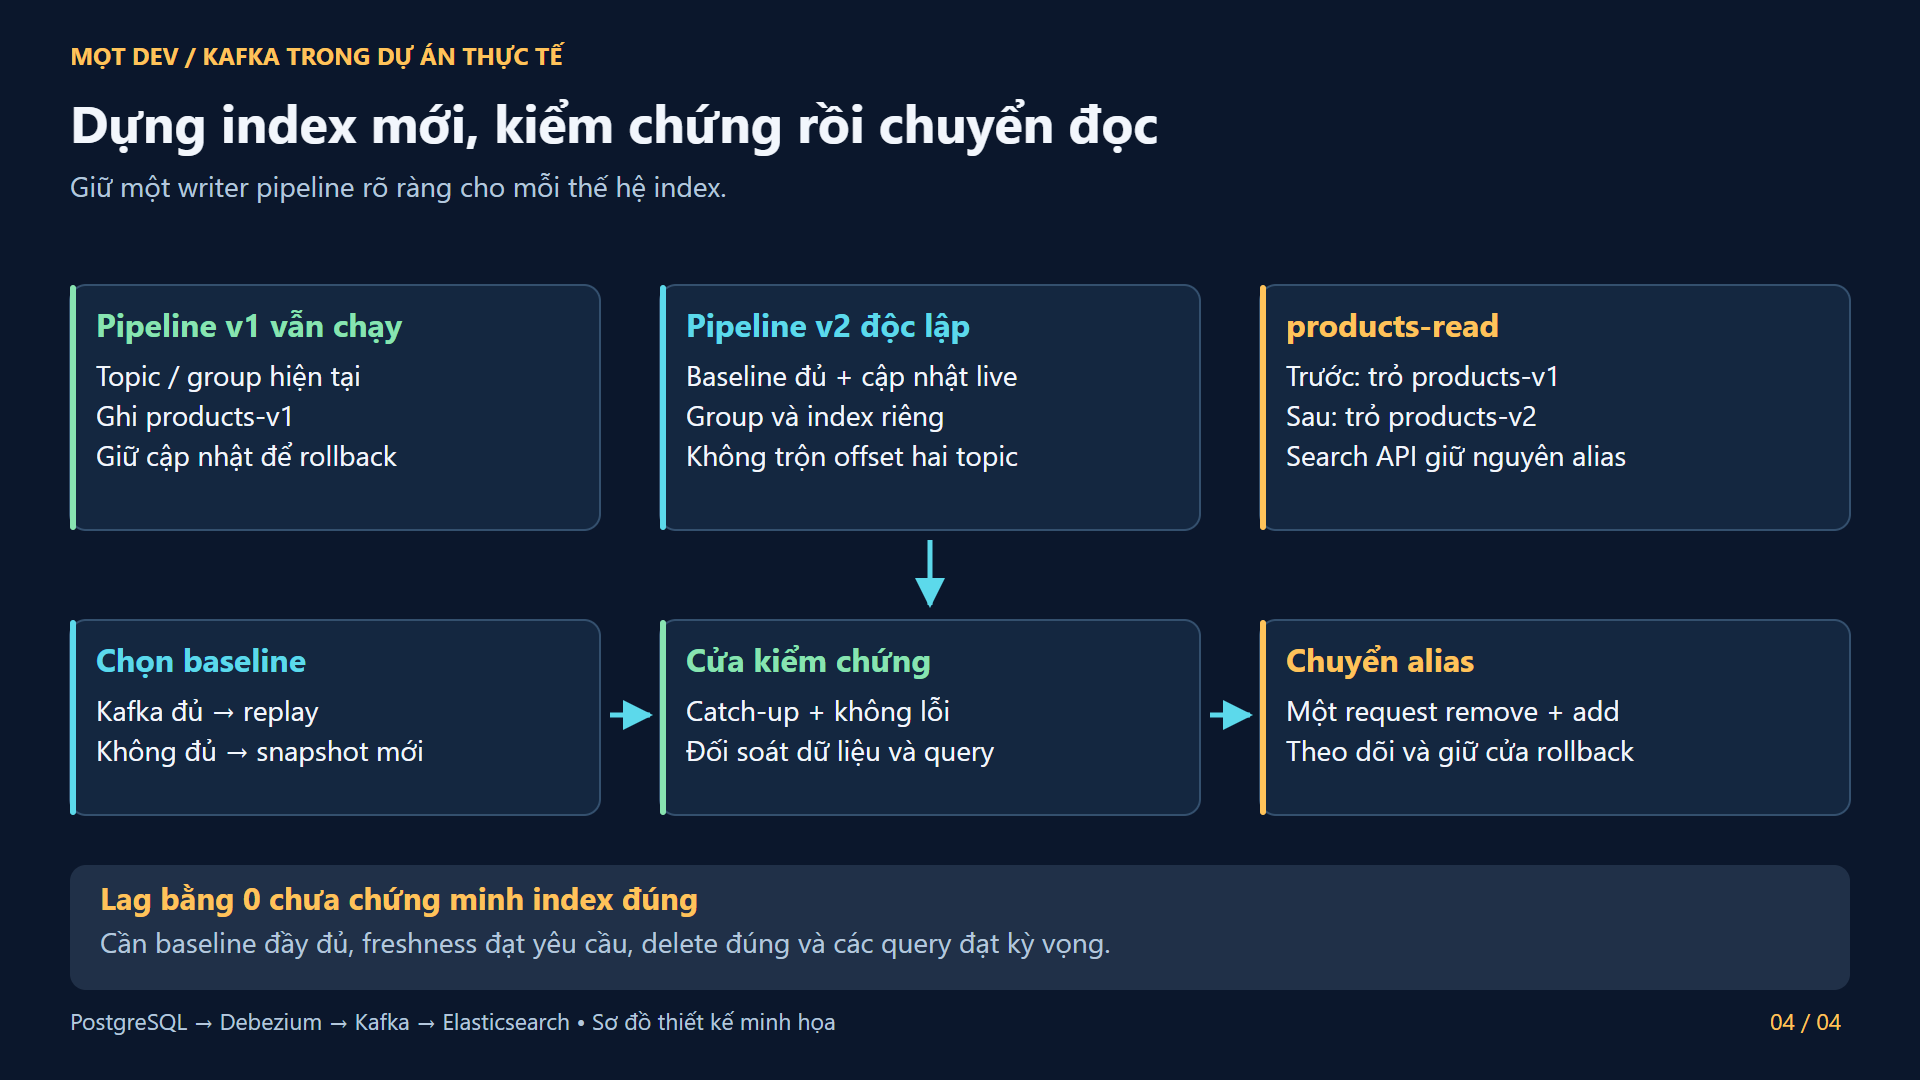
Mở sơ đồ kích thước đầy đủ: Dựng index mới, đối soát và chuyển alias
Ta muốn đổi analyzer hoặc kiểu dữ liệu. Không sửa trực tiếp index đang phục vụ rồi hy vọng mọi document cũ tự đổi đúng. Tạo products-v2, đưa dữ liệu vào đó và chuyển đường đọc sau khi kiểm chứng.
11.1. Chọn baseline đủ dữ liệu
Có hai nhánh:
Nhánh A — Kafka còn đủ dữ liệu để tái tạo trạng thái. Tạo sink mới có consumer group độc lập, ghi products-v2, bắt đầu từ earliest cần thiết. Kiểm tra offset thực, đừng mặc định tên connector mới chắc chắn đọc từ đầu. Việc override auto.offset.reset=earliest phụ thuộc worker policy và chỉ có tác dụng khi chưa có offset hợp lệ. Chụp mốc end offset cho từng partition, theo dõi sink vượt mốc rồi tiếp tục chạy live.
Nhánh B — dữ liệu đã hết retention hoặc không chứng minh được tính đầy đủ. Tạo một pipeline bootstrap riêng với connector identity, slot, publication và topic prefix riêng; để connector tạo snapshot nhất quán rồi streaming liên tục vào products-v2. Pipeline v1 vẫn hoạt động. Cách này tăng tải snapshot và giữ WAL, cần capacity/giới hạn concurrency. Không tái sử dụng slot của source đang chạy. Nếu tách pipeline tạm, phải có bước dọn slot/publication đúng chủ sở hữu sau khi migration hoàn tất.
Trong nhánh B, offset của hai topic không có thứ tự chung. Sau khi chuyển alias, giữ pipeline v2 làm nguồn live của v2; không chuyển writer trở lại topic cũ tùy tiện. Muốn hợp nhất pipeline sau đó cần migration riêng hoặc protocol business version đã được thiết kế.
11.2. Vì sao “lag bằng 0” chưa đủ để chuyển?
Lag có thể bằng 0 vì dữ liệu bị skip, connector đọc sai topic hoặc bắt đầu từ latest. Ta cần một bộ bằng chứng:
Baseline đầy đủ và snapshot hoàn tất.
Sink áp dụng thành công qua các mốc offset cần thiết, vẫn chạy live.
Không có lỗi mapping/record chưa xử lý; freshness dưới ngưỡng.
So sánh count theo nhóm phù hợp và sample ID, giá, trạng thái, delete.
Chạy bộ query relevance/filter tiêu biểu trên v2.
Hệ thống đang ghi liên tục thì count DB và search ở hai thời điểm khác nhau không buộc phải bằng nhau. Đối soát chính xác cần một ranh giới chung, hoặc một cửa sổ tạm dừng ghi có kiểm soát. Với yêu cầu tìm kiếm eventual consistency, có thể định nghĩa mức sai lệch và cách đo phù hợp, nhưng phải nói rõ đó là tiêu chí nào.
11.3. Chuyển alias và rollback
Search API chỉ đọc products-read. Ban đầu alias trỏ v1; sink ghi trực tiếp vào tên index vật lý. Khi v2 đạt tiêu chí, gửi một request:
POST /_aliases
Content-Type: application/json

{
  "actions": [
    { "remove": { "index": "products-v1", "alias": "products-read", "must_exist": true } },
    { "add":    { "index": "products-v2", "alias": "products-read" } }
  ]
}
Alias API hỗ trợ chuyển alias bằng nhiều action trong một thao tác atomic. must_exist=true giúp tránh trường hợp remove lỗi nhưng add vẫn thực hiện; cần kiểm tra response và trạng thái alias sau request. Nó không xác nhận dữ liệu v2 đúng, cũng không phải transaction với PostgreSQL. Xem Elasticsearch Aliases — multiple actions và Update Aliases API.
Giữ v1 và pipeline của v1 chạy thêm trong cửa sổ rollback đã định. Nếu dừng cập nhật v1 ngay sau chuyển, rollback vài giờ sau sẽ trả dữ liệu cũ. Trước rollback, xác minh v1 còn bắt kịp và schema ứng dụng vẫn tương thích. Sau cửa sổ rollback mới dọn tài nguyên theo runbook.
12. Schema evolution và dữ liệu nhiều bảng
12.1. Thêm trường
Giả sử thêm color. Trong ví dụ dùng dynamic: strict, thứ tự triển khai nên là: chuẩn bị mapping/projection chấp nhận field mới, triển khai thay đổi DB/producer, rồi backfill và kiểm chứng document cũ. Thêm cột DB không bảo đảm mọi document cũ lập tức có field mới nếu không phát update/snapshot phù hợp.
12.2. Đổi kiểu
Nếu price_vnd từ integer bị thay thành chuỗi "790.000 đ", sink có thể lỗi mapping. Hợp đồng nên giữ dữ liệu máy đọc được và để UI format. Đổi đơn vị hoặc ý nghĩa field cần version/migration rõ; cùng kiểu long vẫn có thể đổi nghĩa từ đồng sang xu và làm dữ liệu sai mà không có exception.
12.3. Join nhiều bảng
Giả sử document có brand_name lấy từ bảng brands. Brand đổi tên nhưng bảng products không đổi: chỉ nghe products sẽ không cập nhật các document liên quan.
Ba lựa chọn cho thiết kế tiếp theo:
Giữ một bảng projection phục vụ search, cập nhật nó theo các ranh giới transaction đã xác định rồi CDC bảng này.
Dùng stream processor có state và join, xử lý cả update/delete ở hai phía, rekey và rebuild state.
Viết projector riêng, có cơ chế fan-out cập nhật những sản phẩm thuộc brand; kiểm soát race khi đọc DB và việc replay đọc trạng thái hiện tại.
SMT chỉ biến đổi từng record. Nó không trở thành một engine join vì ta đặt thêm vài field trong JSON config. Đây là điểm nối sang buổi Kafka Streams, nhưng cần một bài thực hành riêng để làm đầy đủ.
13. Quan sát pipeline từ góc nhìn người dùng
Dashboard cho case study nên có bốn nhóm tín hiệu:
Lớp: PostgreSQL. Tín hiệu: Slot active, WAL distance, free disk, snapshot load. Câu hỏi cần trả lời: Nguồn còn khả năng phục hồi bao lâu?
Lớp: Connect/Kafka. Tín hiệu: Task state, error/restart, throughput, consumer lag và tuổi backlog. Câu hỏi cần trả lời: Dữ liệu kẹt ở chặng nào?
Lớp: Elasticsearch. Tín hiệu: Bulk failures, rejected requests, indexing/refresh latency, disk. Câu hỏi cần trả lời: Đích xử lý được tải live cộng catch-up không?
Lớp: Nghiệp vụ. Tín hiệu: Commit-to-search freshness, missing/stale document, delete correctness. Câu hỏi cần trả lời: Người dùng có thấy dữ liệu đúng và đủ mới không?
Một canary hữu ích trong môi trường thử nghiệm: cập nhật một sản phẩm chuyên dùng, ghi thời điểm commit từ hệ thống đo, query search đến khi thấy marker mới rồi đo thời gian. Hạn chế tần suất và tách khỏi dữ liệu bán hàng. Cách đo này kiểm tra cả refresh/query path mà lag offset không phản ánh hết.
Đồng bộ clock khi tính latency từ nhiều máy. Với snapshot, timestamp của dữ liệu có thể rất cũ nhưng pipeline vẫn khỏe; không đánh đồng tuổi sản phẩm với tuổi backlog.
CDC có thể truyền cả giá trị trước khi xóa. Chỉ capture các bảng/cột cần thiết, hạn chế quyền đọc topic, bảo vệ Connect REST và internal topics. Xóa document khỏi Elasticsearch không xóa bản sao trong Kafka, backup hay DLT; phạm vi retention phải được thiết kế cho từng nơi lưu.
14. Kịch bản kiểm chứng trước khi quay demo
Các dòng dưới là test plan và kết quả kỳ vọng, chưa phải log test đã chạy. Chuẩn bị một lab riêng với version đã pin, không dùng database của blog.
Cảnh thử: Snapshot. Thao tác: Có sản phẩm trước khi bật source. Bằng chứng cần ghi hình: Record snapshot và document tương ứng
Cảnh thử: Update. Thao tác: Đổi giá 1001 thành 790.000. Bằng chứng cần ghi hình: Cùng
_id, document mới, query thấy giá sau refreshCảnh thử: Delete. Thao tác: Xóa 1001. Bằng chứng cần ghi hình: Record delete, tombstone, document không còn
Cảnh thử: Soft delete. Thao tác: Đặt active=false ở sản phẩm khác. Bằng chứng cần ghi hình: Document còn, query public loại ra
Cảnh thử: Restart sink. Thao tác: Dừng/restart quanh lúc xử lý batch. Bằng chứng cần ghi hình: Không nhân đôi sản phẩm; cuối cùng trạng thái khớp DB
Cảnh thử: Elasticsearch down. Thao tác: Dừng đích, tiếp tục update DB. Bằng chứng cần ghi hình: Sink lag tăng; phục hồi rồi backlog giảm
Cảnh thử: Source down. Thao tác: Dừng source, tiếp tục ghi DB. Bằng chứng cần ghi hình: WAL distance tăng; resume được khi WAL còn
Cảnh thử: Schema lỗi. Thao tác: Trong lab thêm field ngoài strict mapping. Bằng chứng cần ghi hình: Task lỗi rõ; không im lặng tuyên bố đã đồng bộ
Cảnh thử: Rebuild. Thao tác: Tạo v2, sink/group độc lập. Bằng chứng cần ghi hình: Bắt đầu đúng offset, sample khớp, chuyển alias
Cảnh thử: Dữ liệu hết retention. Thao tác: Dùng topic lab giới hạn ngắn. Bằng chứng cần ghi hình: Phát hiện thiếu baseline và chọn snapshot mới
Lệnh SQL cho update/delete đã có ở phần 4; lệnh delete riêng cho sản phẩm lab:
DELETE FROM public.products WHERE id = 1001;Khi quay, nên hiển thị đồng thời bốn cửa sổ: DB query, Kafka record, connector status và Elasticsearch query. Không chỉ quay status RUNNING: task chạy không chứng minh row đang xem đã đồng bộ đúng. Hãy ghi lại _id, giá và record offset cụ thể để người xem theo được một sản phẩm xuyên suốt.
15. Những câu hỏi cần trả lời được sau bài này
Tại sao không cho API ghi DB và Elasticsearch luôn? Vì hai hệ thống không nằm trong một transaction của đoạn code đó. CDC chuyển trách nhiệm theo dõi thay đổi đã commit sang pipeline bền vững, nhưng ta vẫn phải quản lý backlog, snapshot và phục hồi.
Kafka chết có làm API cập nhật catalog chết theo không? API ở thiết kế này không gọi Kafka trực tiếp. Tuy vậy, gián đoạn lâu có thể làm nguồn tích WAL, cạn disk và ảnh hưởng DB. Sự độc lập là có giới hạn tài nguyên.
Cùng key có nghĩa là không bao giờ sai thứ tự? Cần giữ key serialization, partition mapping và đường xử lý ổn định. Đổi partition count, nhiều writer hoặc republish payload cũ đều có thể phá giả định nghiệp vụ.
Dùng Outbox thay CDC bảng products có tốt hơn không? Nếu cần event với ý nghĩa nghiệp vụ ổn định thì có lý do chọn Outbox. Nếu chỉ cần phản chiếu row hiện tại và mọi đường ghi đã đi vào DB, CDC bảng đó đơn giản hóa phía ứng dụng. Chọn theo hợp đồng cần công bố.
Có thể rebuild từ earliest bất cứ lúc nào không? Earliest là record còn giữ, không phải ngày đầu hệ thống tồn tại. Phải chứng minh topic đủ dữ liệu cho trạng thái hiện tại, hoặc tạo baseline mới.
Khi nào được chuyển alias? Khi baseline đầy đủ, pipeline mới bắt kịp theo tiêu chí freshness, không có lỗi chưa xử lý, đối soát dữ liệu và query đạt yêu cầu, đường rollback còn cập nhật.
16. Kết luận
Một pipeline CDC hữu ích vì nó nối một transaction nghiệp vụ với các mô hình đọc có thể phục hồi. Phần khó nằm ở hợp đồng key, delete, snapshot, retention và ranh giới checkpoint. Với bài toán catalog, hãy đo “sản phẩm xuất hiện đúng trong tìm kiếm sau bao lâu”, đồng thời biết cách dựng lại search khi index cũ không còn dùng được.
Có thể học bài này thành hai phần: cơ chế và cấu hình; sự cố và rebuild. Trước khi chạy production, hãy hoàn thành ma trận kiểm chứng bằng một lab riêng với phiên bản đã cố định.
Nguồn tham khảo chính thức
Các liên kết được đặt gần nội dung liên quan. Những quyết định về SLO, topology, retention, rollout và test plan trong bài là phương án đề xuất cho case study, không phải mặc định bắt buộc của các sản phẩm.
Site Admin
Engineer and writer. Building things with TypeScript and distributed systems.
Bình luận (0)
Bạn cần đăng nhập bằng Google để bình luận.
Hãy là người bình luận đầu tiên.