System Design — Bài 9: Caching và Redis: chiến lược ghi, rate limit và các bẫy thường gặp
Một key nóng hết hạn có thể khiến hàng nghìn request cùng xuống database. Cache vốn dùng để giảm tải lại trở thành nguồn gây quá tải. Để dùng Redis đúng, cần phân biệt dữ liệu có thể tái tạo với trạng thái nghiệp vụ, rồi thiết kế cả lúc hit, miss và mất cache.
Khóa học System Design: mục lục 21 bài — bạn đang đọc bài 9.
Cache ở đâu, và để làm gì
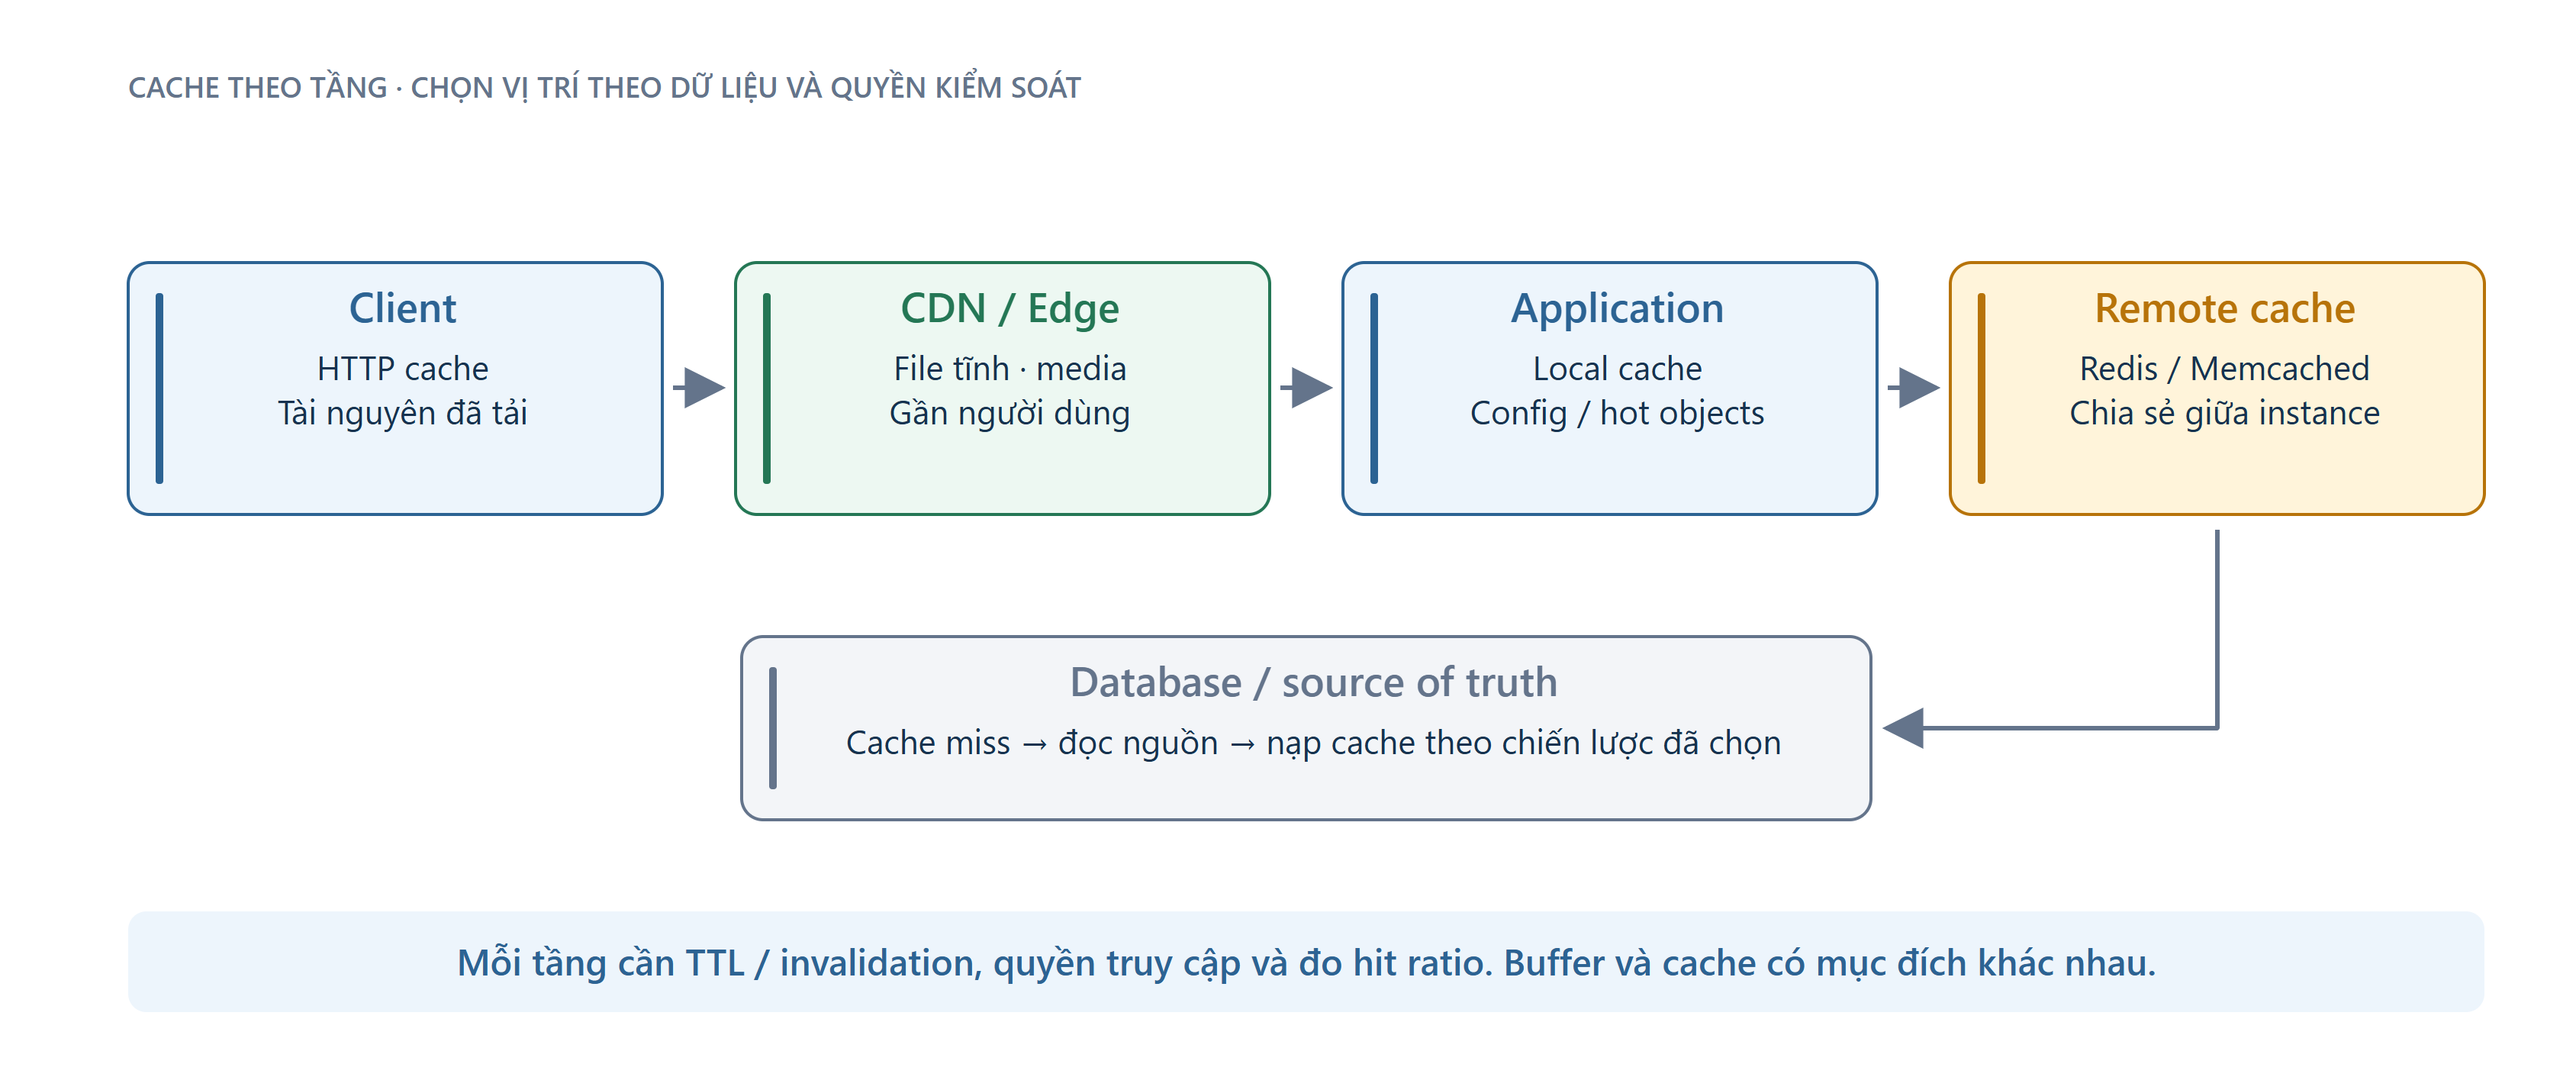
Xem sơ đồ đầy đủ: Cache ở đâu, và để làm gì
Cache có thể ở trình duyệt, CDN, proxy, trong tiến trình hoặc một kho dùng chung. Đặt gần nơi dùng giảm chi phí truy cập, nhưng càng nhiều bản sao thì càng khó làm mới nhất quán.
Một cache đúng nghĩa thường giữ dữ liệu có thể lấy lại từ nguồn khác. Nếu dùng Redis để giữ công việc chưa được lưu ở đâu khác, nó đang đóng vai trò buffer hoặc kho trạng thái; khi đó phải nghĩ về durability và recovery. Cùng một sản phẩm có thể đóng nhiều vai trò, nhưng mức bảo đảm cần thiết không giống nhau.
TTL giới hạn tuổi theo chính sách, eviction thu hồi chỗ khi thiếu bộ nhớ, còn invalidation xử lý dữ liệu đã thay đổi. Chúng không thay thế nhau hoàn toàn. Trước khi thêm cache, hãy biết nguồn sự thật và mức dữ liệu cũ nghiệp vụ chấp nhận được.
Ba chiến lược ghi cache
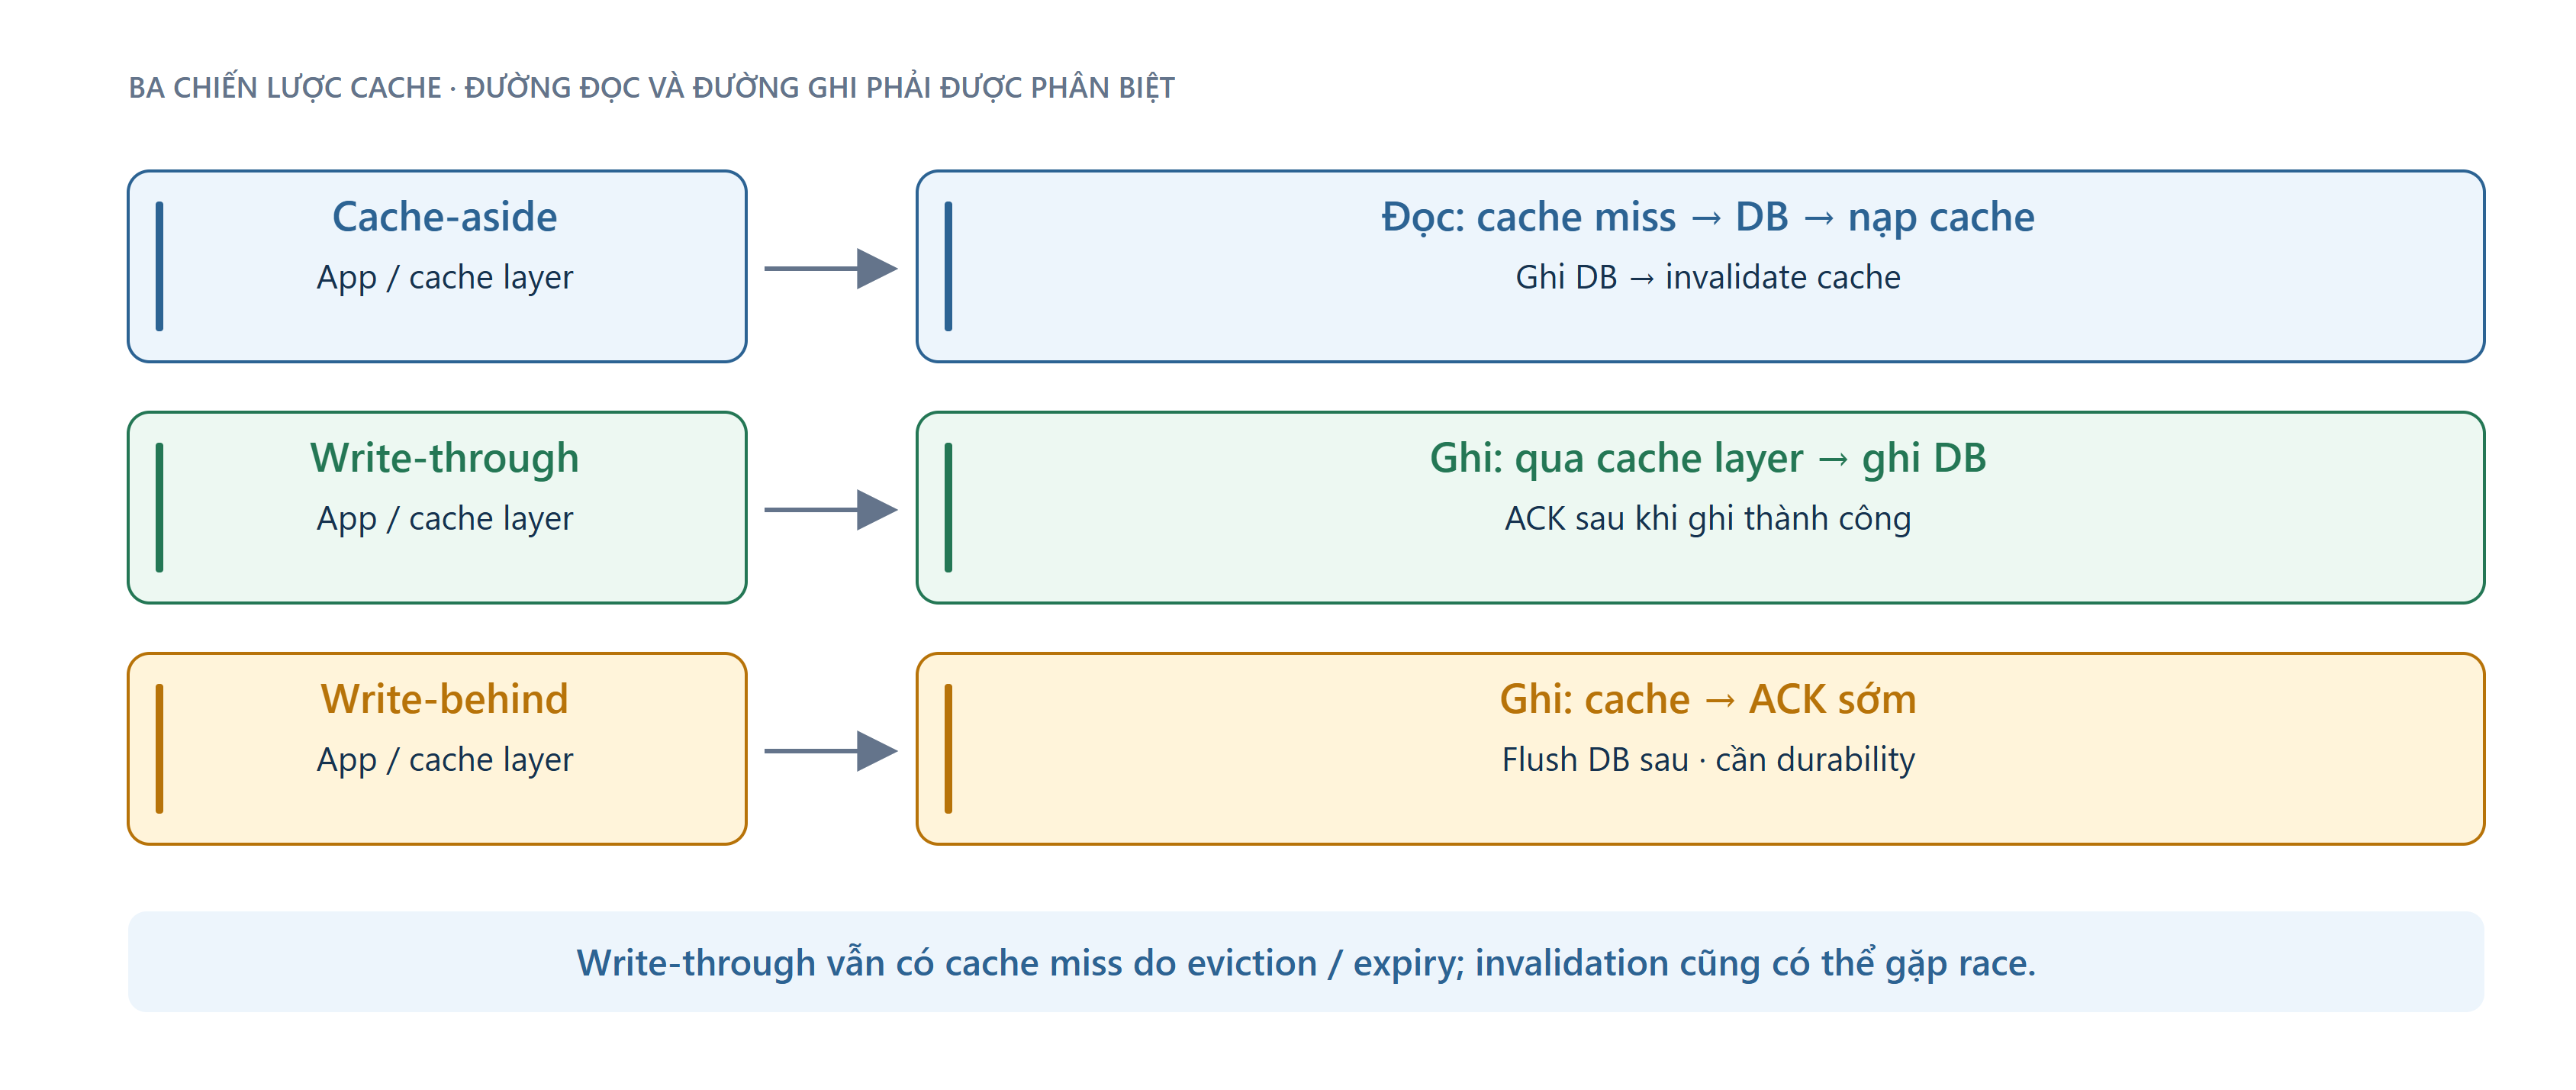
Xem sơ đồ đầy đủ: Ba chiến lược ghi cache
Cache-aside để ứng dụng tự đọc cache, nếu miss thì đọc database rồi nạp cache. Khi cập nhật, cách thường gặp là ghi database rồi xóa key liên quan. Cần nhớ vẫn có race: một lượt đọc cũ đang chạy có thể nạp lại cache sau khi key bị xóa. TTL, version hoặc cơ chế đồng bộ bổ sung giúp xử lý theo yêu cầu.
Write-through đi qua lớp cache và cập nhật kho bền trước khi xác nhận theo thiết kế của hệ thống. Nó không tự bảo đảm luôn hit, vì vẫn có eviction, lỗi và dữ liệu chưa từng nạp. Write-behind xác nhận sớm rồi ghi xuống sau, giúp gom ghi nhưng cần đối diện nguy cơ mất phần chưa flush.
Chọn chiến lược bằng mức chấp nhận stale read, độ trễ ghi và khả năng mất dữ liệu. Dù chọn cách nào, cần mô tả lỗi giữa các bước thay vì chỉ đường đi thành công.
Bốn cái bẫy của cache
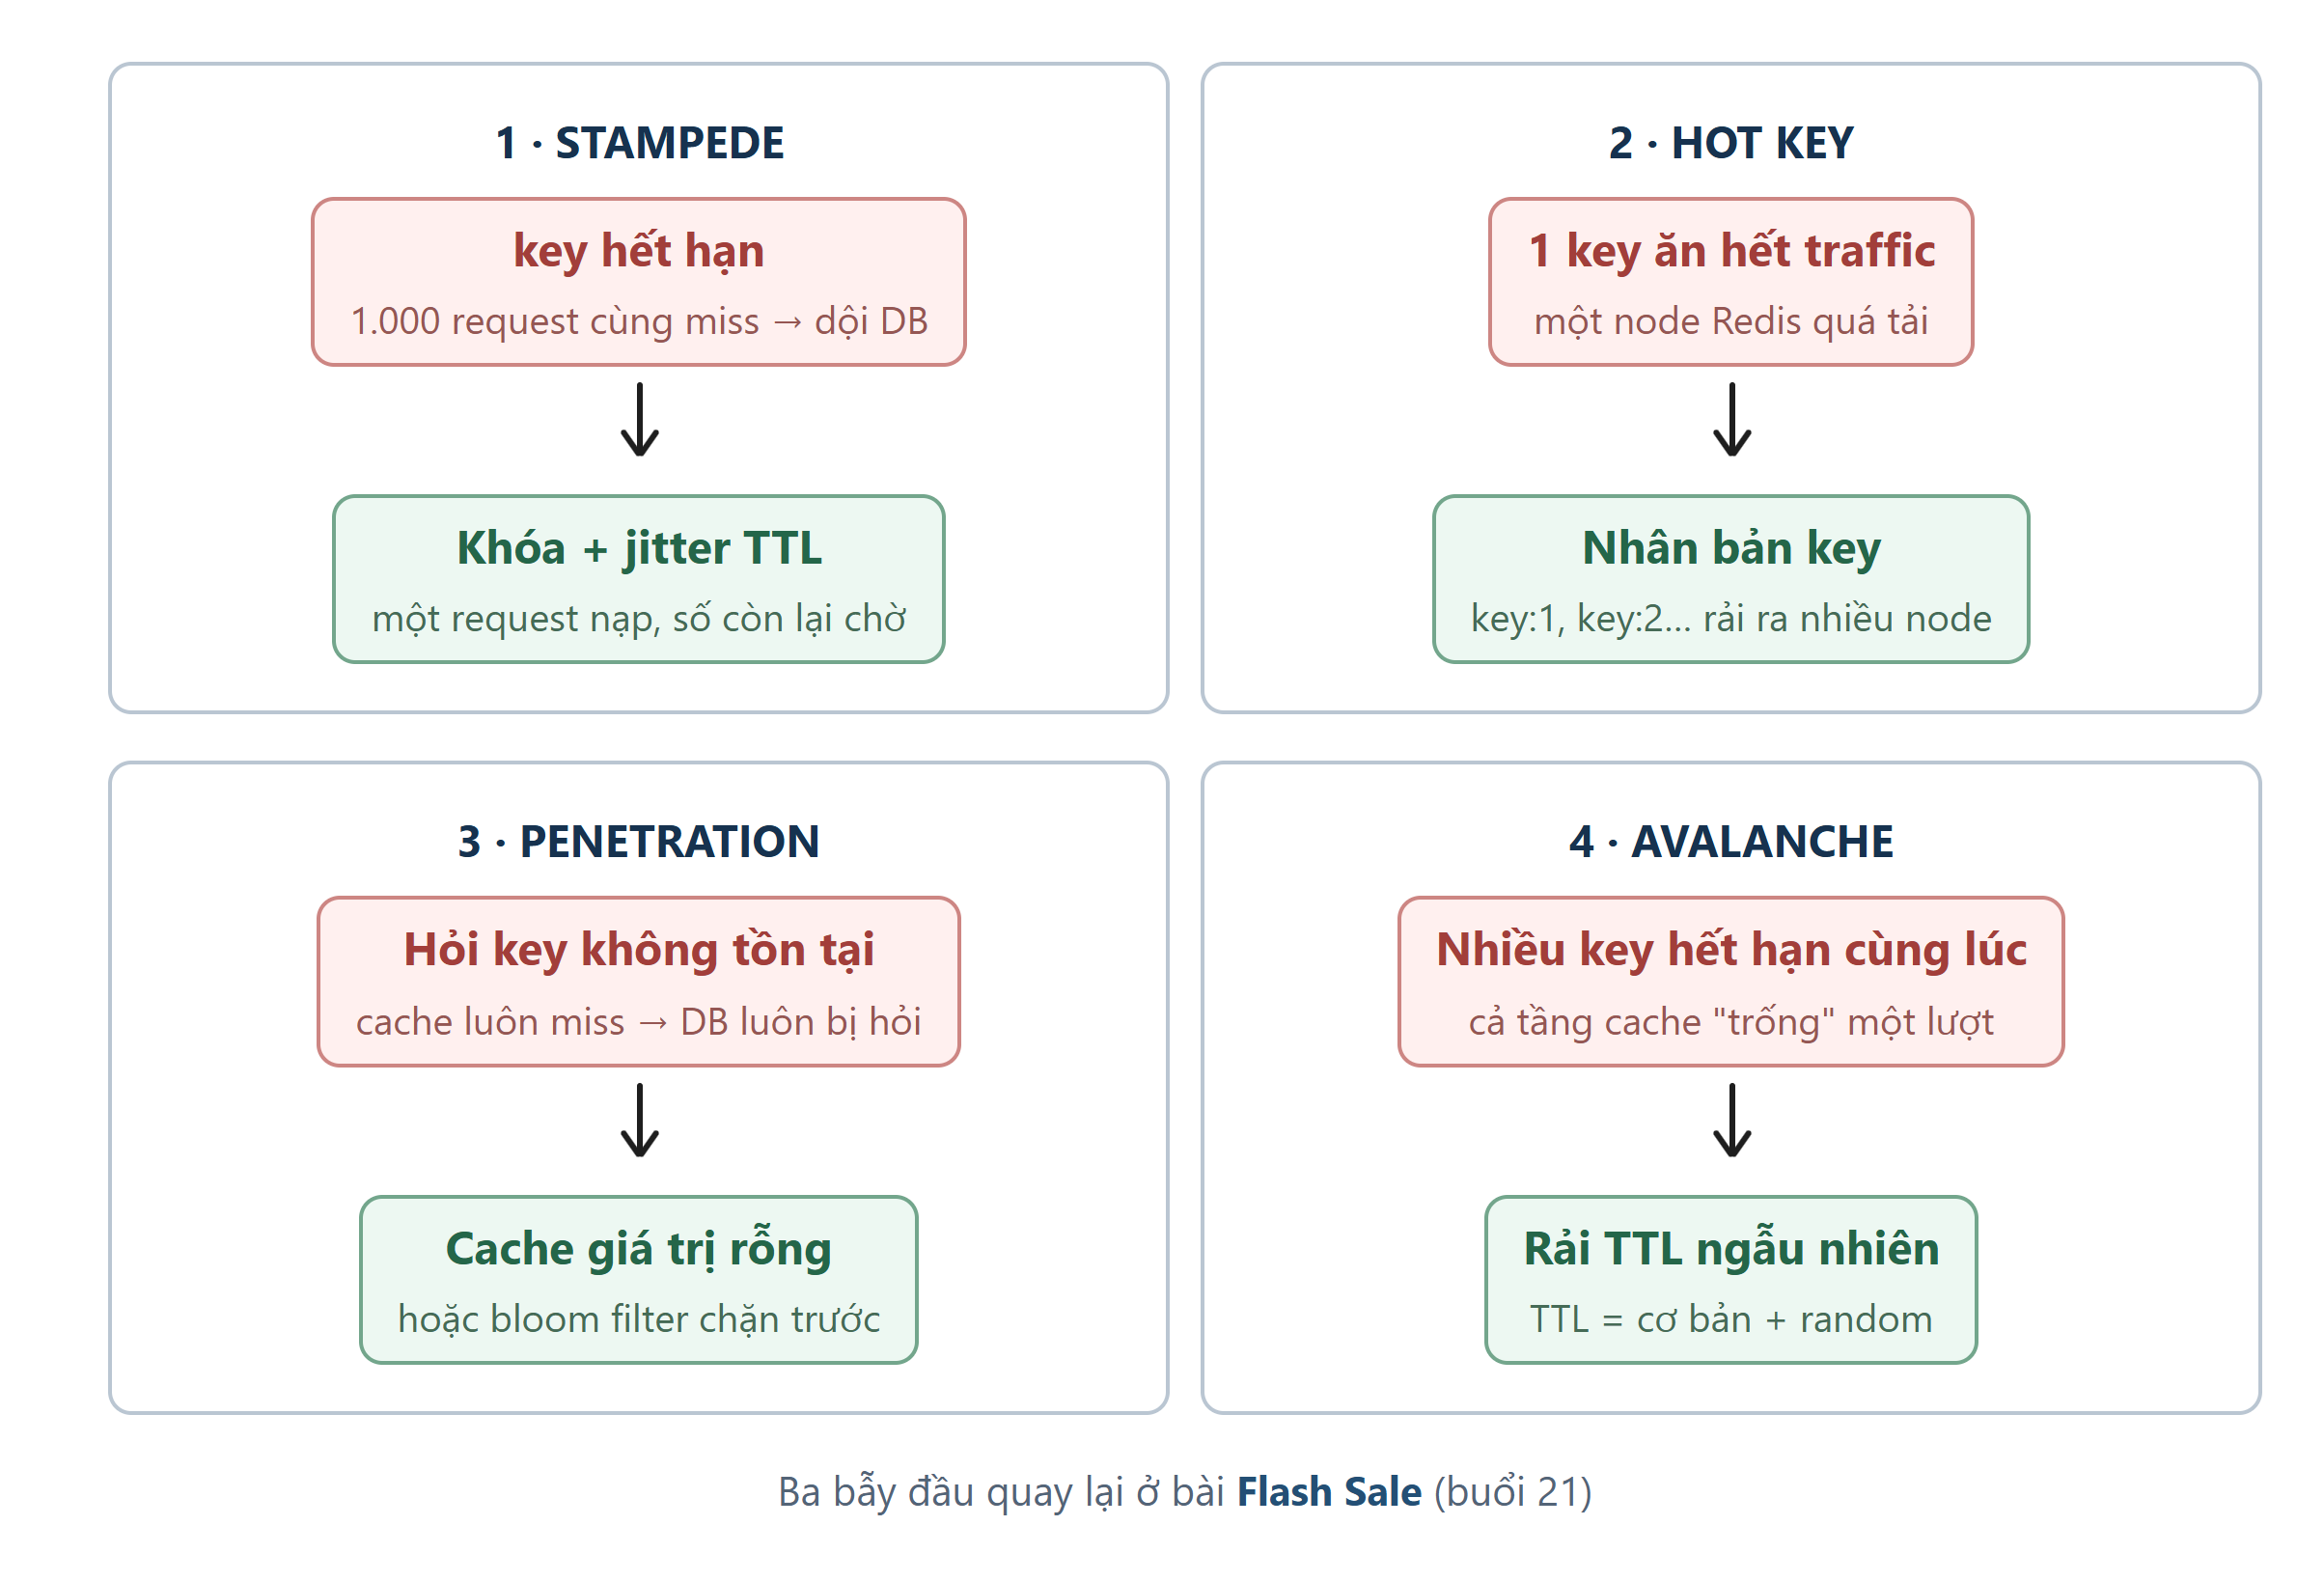
Xem sơ đồ đầy đủ: Bốn cái bẫy của cache
Stampede xảy ra khi một dữ liệu nóng hết hạn và nhiều request cùng xuống database. Có thể gom các lượt tải lại thành một công việc, làm mới sớm hoặc cho phép dùng bản cũ trong khoảng đã chấp nhận. Jitter giúp tránh nhiều key hết hạn đồng loạt, nhưng riêng một hot key vẫn cần cơ chế phối hợp.
Hot key dồn tải lên một điểm. Có thể dùng cache cục bộ hoặc nhân bản phần đọc, nhưng phải xử lý làm mới và tính đúng đắn. Không được tùy tiện nhân bản counter cần cập nhật chính xác rồi giả định mọi bản giống nhau.
Penetration là nhiều lượt hỏi dữ liệu không tồn tại, có thể giảm bằng cache kết quả rỗng hoặc bộ lọc phù hợp. Avalanche là hàng loạt cache cùng mất hiệu lực, cần TTL phân tán, warm-up có kiểm soát và bảo vệ database. Các cách chữa phải nhắm đúng loại lỗi.
Redis trong production — số và kiến trúc
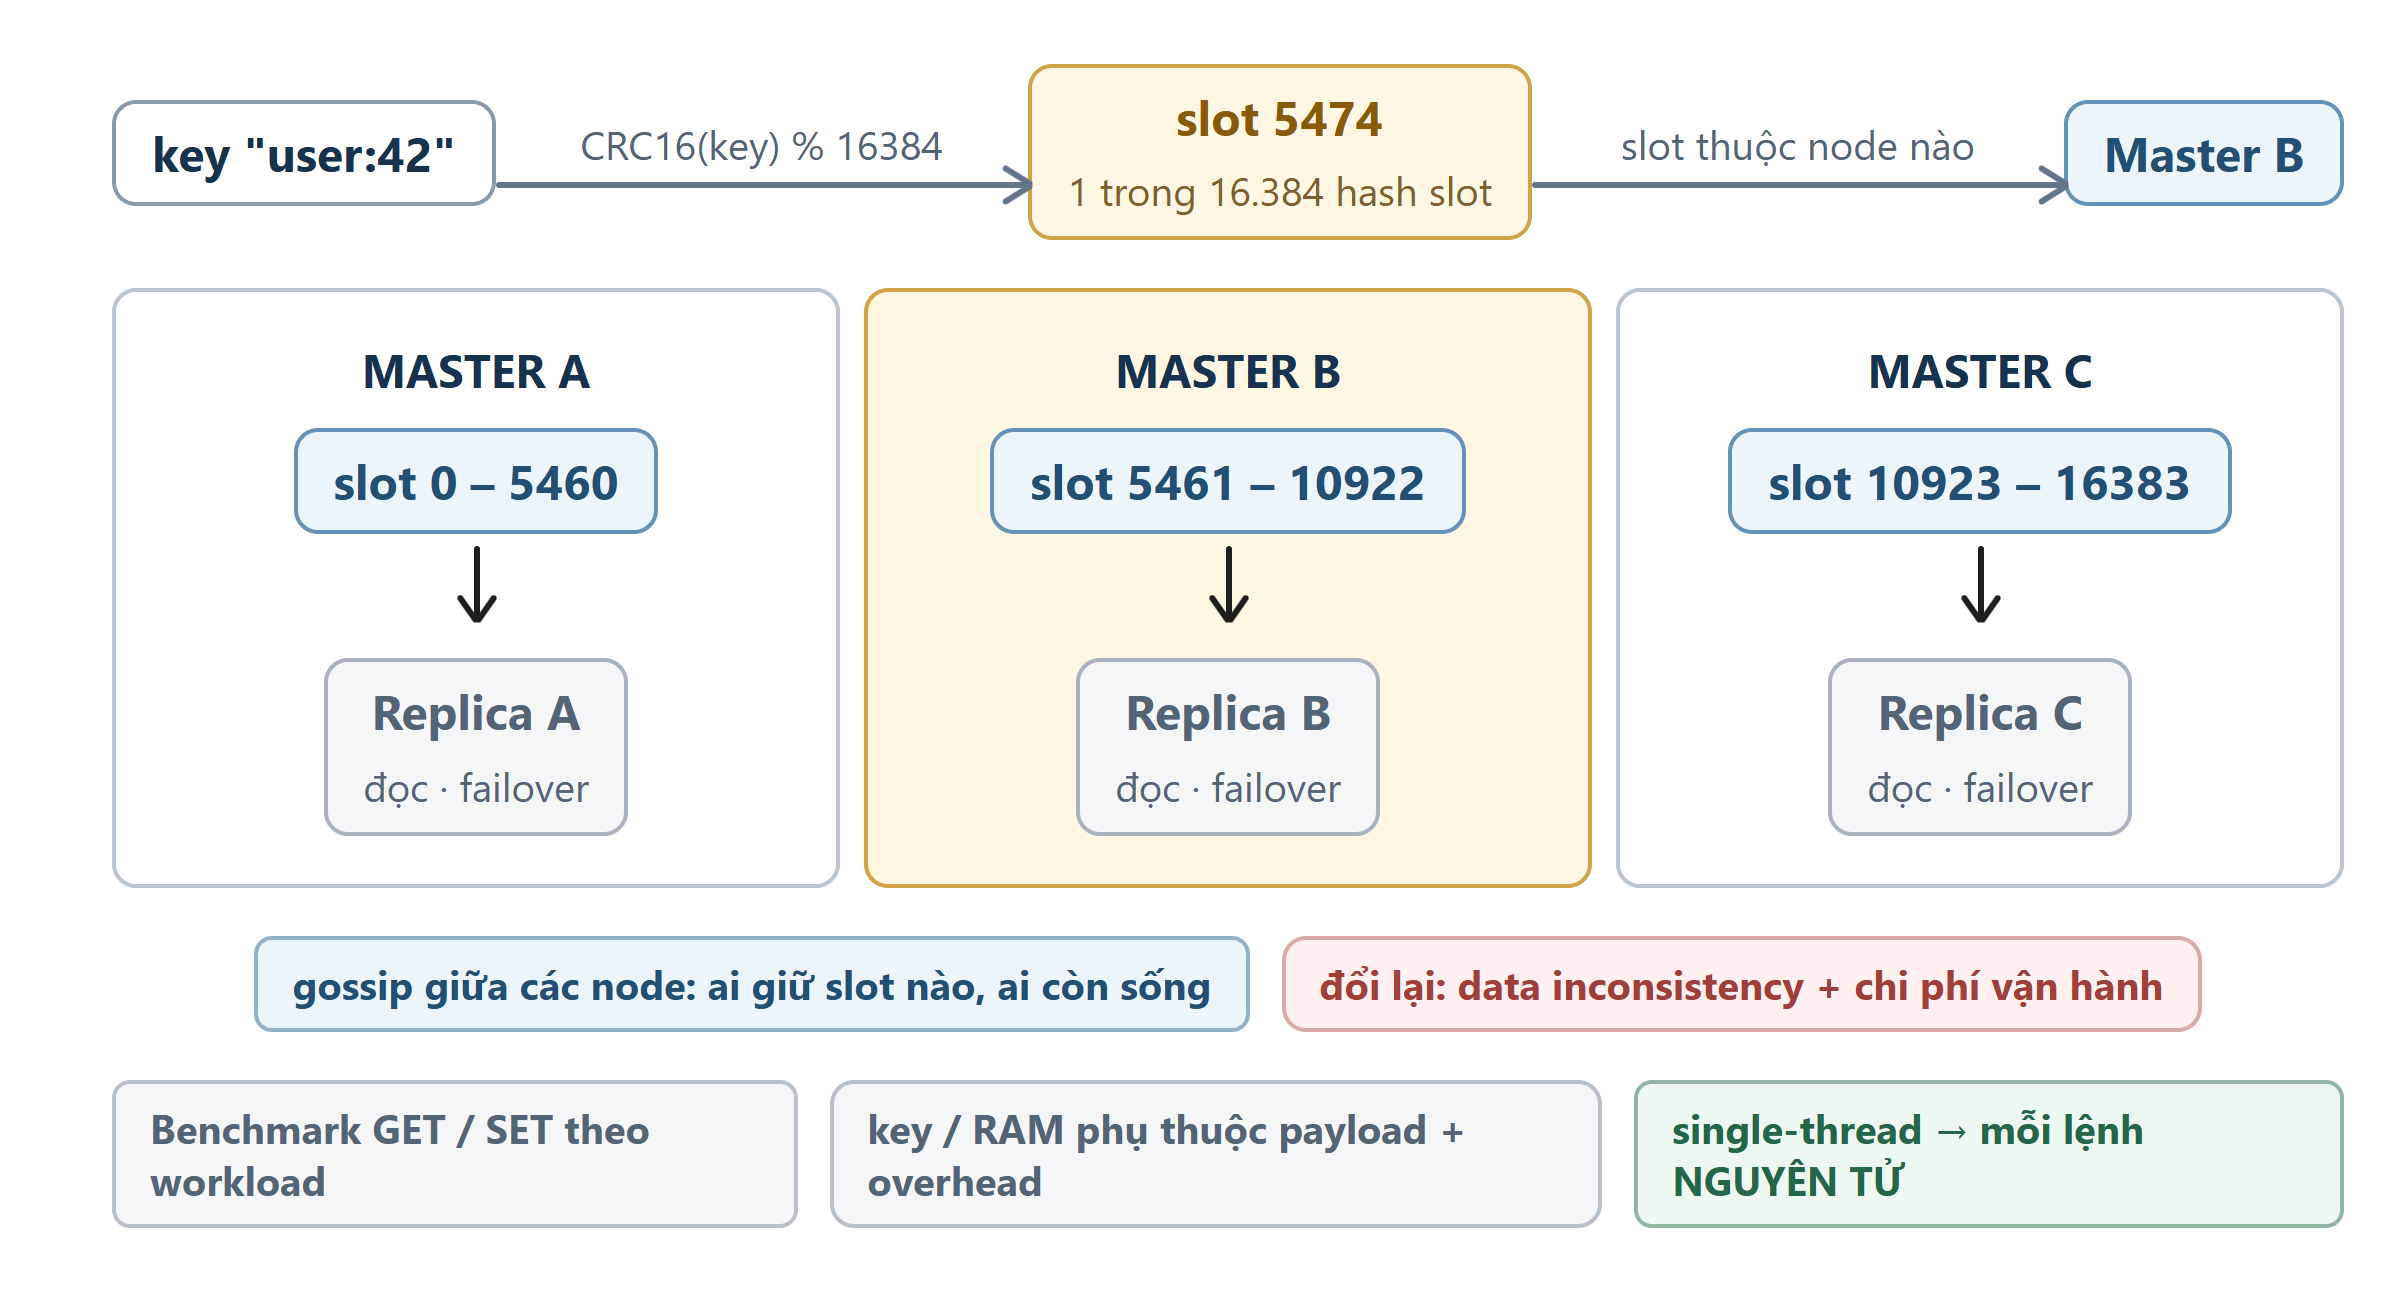
Xem sơ đồ đầy đủ: Redis trong production — số và kiến trúc
Redis Cluster chia không gian key thành 16.384 slot, rồi phân các slot cho node. Hash tag có thể giúp các key liên quan cùng slot, hữu ích cho thao tác nhiều key nhưng cũng có thể tạo điểm nóng nếu gom quá nhiều.
Sizing phải tính cả key, metadata, cấu trúc dữ liệu và buffer, không chỉ payload. Throughput phụ thuộc lệnh, kích thước dữ liệu, mạng và pipelining. Lệnh hoặc script dài có thể làm tăng latency của công việc khác, nên tốc độ trung bình chưa đủ để đánh giá.
Một lệnh nguyên tử không biến chuỗi đọc rồi ghi từ client thành nguyên tử. Khi cần phối hợp nhiều bước, phải dùng cơ chế thích hợp. Replication và failover cũng có thể ảnh hưởng dữ liệu đã ghi; cần xem độ bền và mức mất dữ liệu chấp nhận được thay vì suy từ tính nguyên tử của lệnh.
Rate limiting — bốn thuật toán
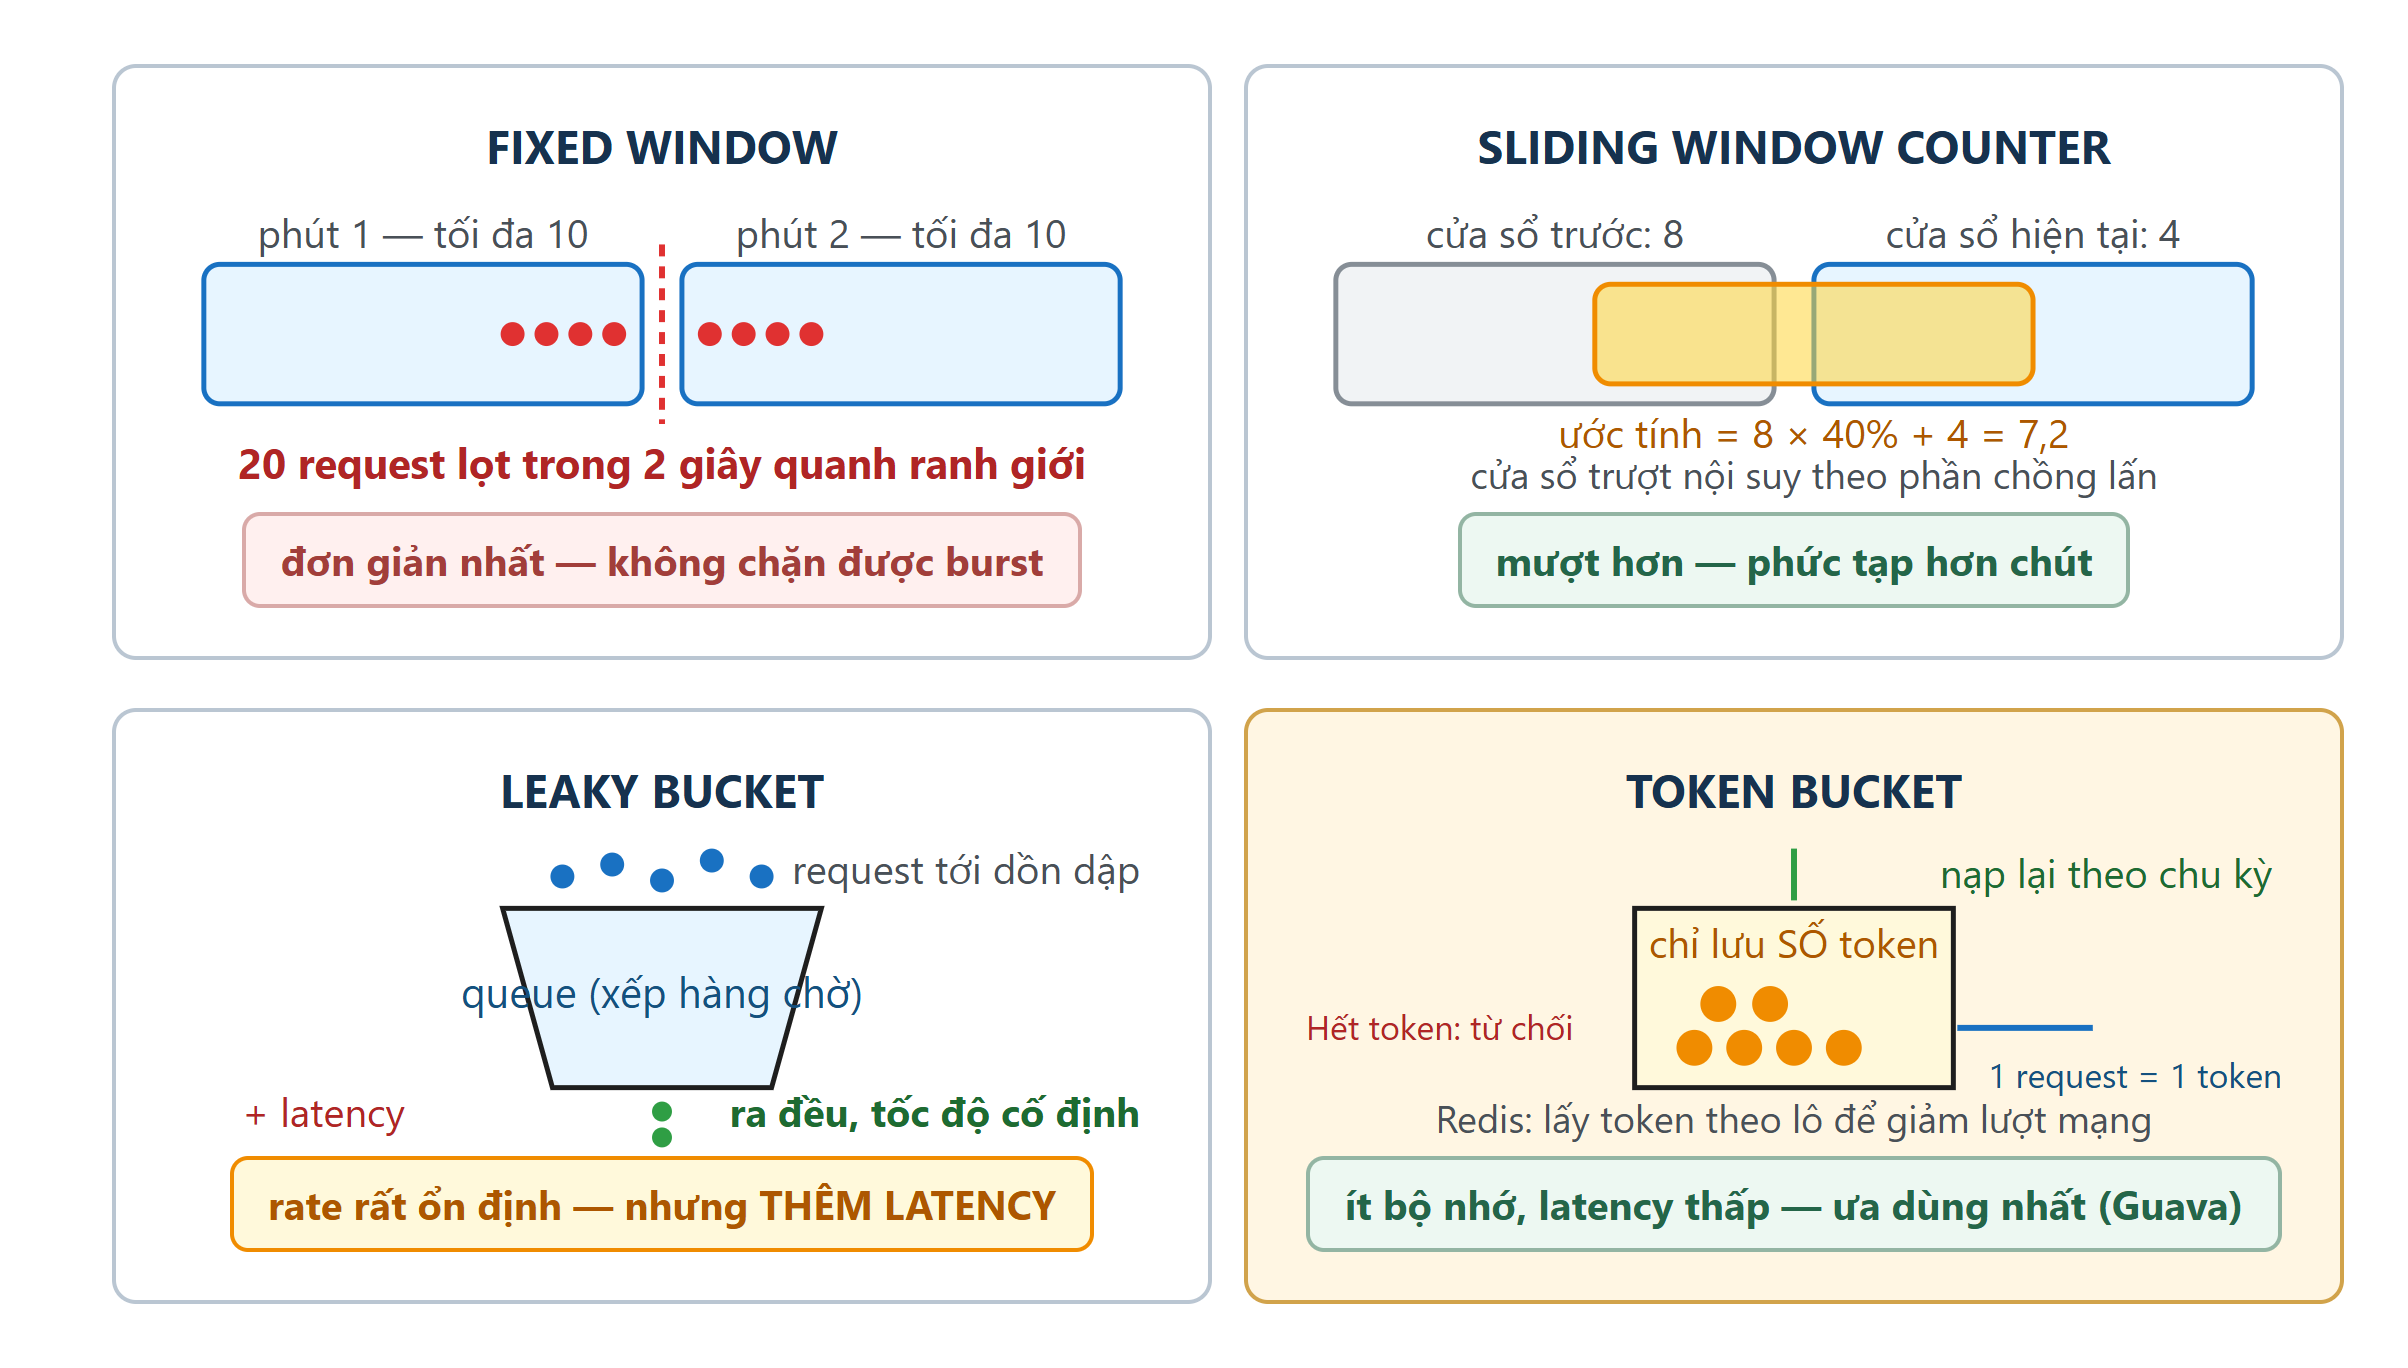
Xem sơ đồ đầy đủ: Rate limiting — bốn thuật toán
Fixed window đếm trong từng khoảng cố định. Nếu giới hạn mười request mỗi phút, client có thể gửi mười ở cuối phút trước và mười ở đầu phút sau, tạo burst lớn trong vài giây. Sliding window counter ước lượng lượng dùng gần đây mượt hơn, nhưng vẫn là xấp xỉ tùy cách triển khai.
Leaky bucket xả công việc với tốc độ ổn định khi được triển khai như hàng đợi có giới hạn. Token bucket tích token theo tốc độ quy định và cho phép burst trong giới hạn sức chứa. Chúng phù hợp các mục tiêu khác nhau, không có một thuật toán tốt nhất cho mọi luồng.
Trong hệ phân tán, counter chung tăng độ nhất quán nhưng thêm vòng mạng. Cấp token theo lô cho node giảm chi phí, đổi lại cần chấp nhận sai lệch hoặc dự trữ capacity. Khi hết hạn mức, phản hồi phải rõ và chính sách retry phải tránh tạo thêm burst.
Ba case thực chiến với Redis
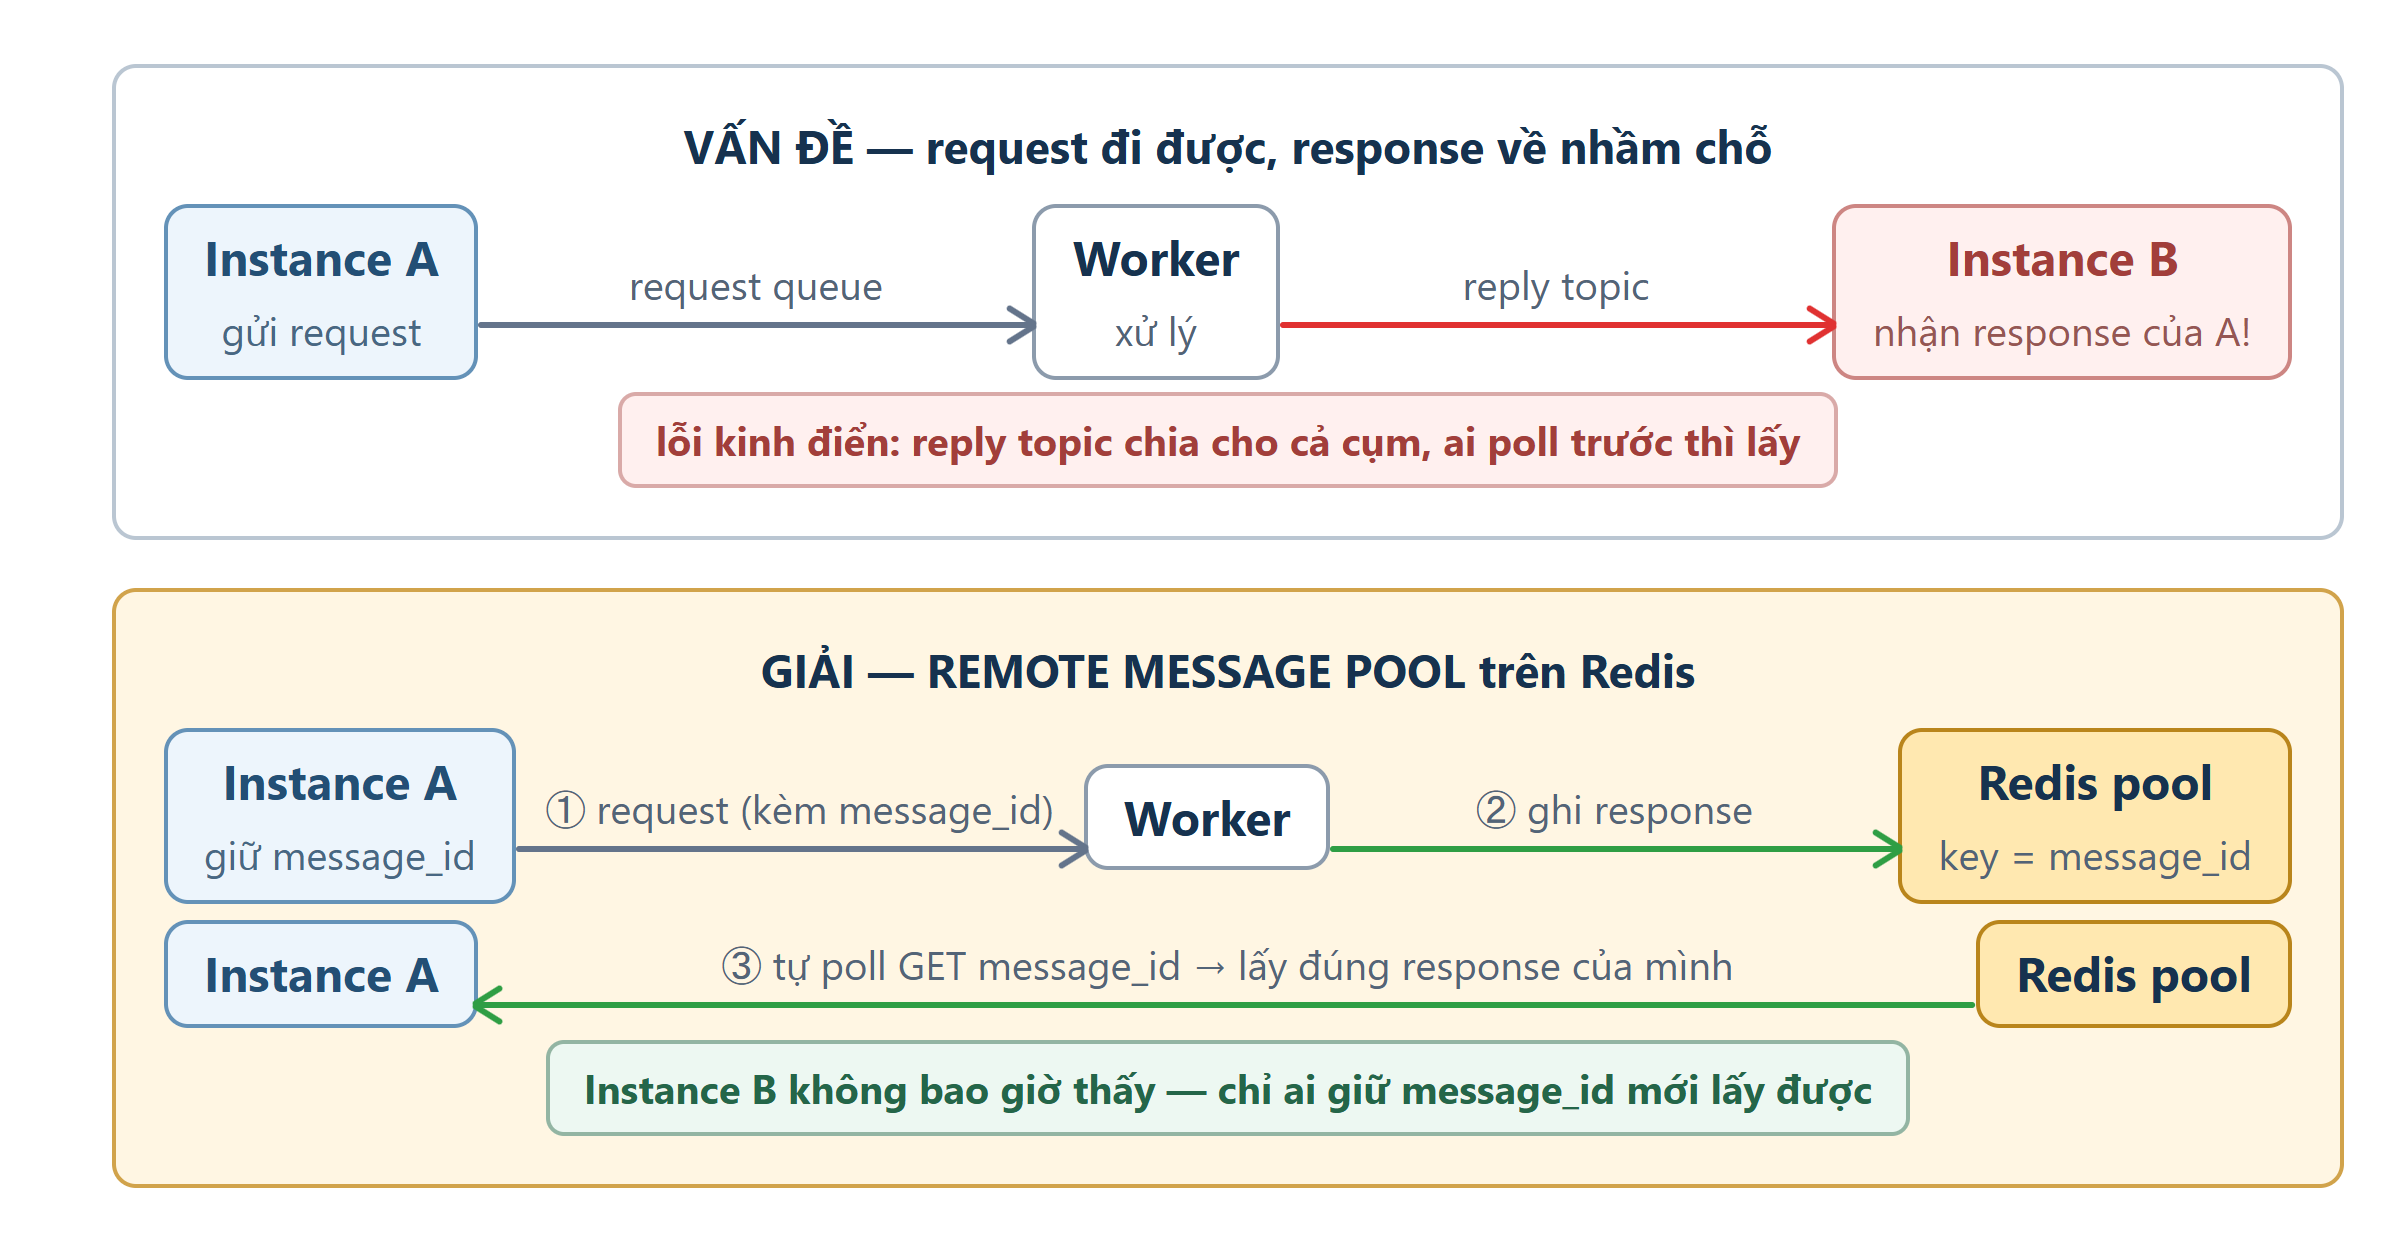
Xem sơ đồ đầy đủ: Ba case thực chiến với Redis
Với counter tương tác, cập nhật nguyên tử tránh lost update tại một nơi xử lý, nhưng không tự chống đếm hai lần khi event được gửi lại. Cần xác định counter chấp nhận gần đúng hay cần dedup và đối soát với nguồn bền vững.
Với thông báo broadcast, thay vì cập nhật số chưa đọc cho mọi người, có thể giữ con trỏ đọc của mỗi user. Chỉ dùng hiệu số sequence để đếm nếu dãy liên tục và mọi mục đều thuộc user đó; khi có xóa hoặc lọc quyền cần logic phù hợp hơn.
Với request–reply qua queue, message_id giúp nối response với đúng request. Một kho response dùng chung cho phép instance gửi tìm kết quả của mình, nhưng cần TTL, timeout, quyền đọc và chi phí polling. Đây là một lựa chọn; reply queue hoặc định tuyến theo correlation cũng có thể phù hợp tùy môi trường.
Năm recipe Redis nên thuộc
Để xử lý check-then-act, có thể dùng WATCH với transaction và retry, hoặc script thực hiện kiểm tra cùng cập nhật trong một lần. Script phải ngắn; tính nguyên tử không có nghĩa được phép chạy tính toán dài tùy ý.
Delayed job có thể dùng sorted set, score là thời điểm đến hạn. Worker vẫn cần cơ chế nhận việc an toàn và phục hồi nếu chết sau khi lấy. HyperLogLog giúp đếm số phần tử khác nhau gần đúng; không dùng khi nghiệp vụ bắt buộc con số tuyệt đối hoặc cần lấy danh sách phần tử.
Bitmap phù hợp tập phần tử ánh xạ được thành vị trí bit, còn Bloom filter sàng lọc khả năng tồn tại. Bloom filter tiêu chuẩn có false positive; nếu dữ liệu nguồn thay đổi mà bộ lọc chưa cập nhật, tính đúng đắn của toàn luồng còn phụ thuộc quy trình đồng bộ. Kết quả “có thể tồn tại” luôn cần lookup xác nhận.
Cache-aside và race cần nhìn thấy
Đọc: GET cache -> hit: trả kết quả
                 miss: đọc DB -> SET cache -> trả kết quả

Ghi: COMMIT DB -> xóa key cache

Race:
A đọc bản cũ từ DB ----[chậm]----> nạp bản cũ vào cache
         B commit bản mới -> xóa cache

Cần chính sách TTL/version/làm mới theo yêu cầu stale read.
Một hot key: single-flight hoặc stale-while-revalidate.
Nhiều key hết hạn cùng lúc: jitter + giới hạn tải xuống DB.
Xóa cache sau ghi không loại bỏ mọi race. Các giải pháp phải đi cùng mức dữ liệu cũ được chấp nhận. Redis script cũng cần ngắn và các key liên quan phải đáp ứng ràng buộc slot khi chạy trên cluster.
Thuật ngữ cần nhớ
TTL — Time To Live: Thời gian sống còn hiệu lực của dữ liệu, bản ghi tên miền hoặc lease. Hết hạn không tự thực hiện nghiệp vụ như hoàn tồn kho; cần luồng xử lý tương ứng.
LRU — Least Recently Used: Chính sách loại dữ liệu ít được truy cập gần đây nhất khi cache thiếu chỗ; bản triển khai có thể dùng xấp xỉ.
RTT — Round-Trip Time: thời gian một lượt trao đổi đi từ bên gửi tới bên nhận rồi phản hồi về; thêm remote cache cũng thêm một lượt mạng.
Bài tập tự thực hành
Một hot key hết hạn làm DB quá tải.
Gợi ý kiểm tra lời giải
Phân biệt stampede và avalanche; cân nhắc single-flight, làm mới sớm, stale policy và bảo vệ DB.
Tự kiểm tra sau bài học
Xác định nguồn sự thật và cách dựng lại cache.
Phân biệt stampede, hot key, penetration và avalanche.
Không dùng HyperLogLog/Bloom filter thay ràng buộc chính xác trong DB.
Tiếp tục lộ trình
Bài trước — Scale dữ liệu: replication, partition và sharding
Bài tiếp — Giao tiếp giữa service: HTTP, gRPC, queue và realtime
Site Admin
Engineer and writer. Building things with TypeScript and distributed systems.
Bình luận (0)
Bạn cần đăng nhập bằng Google để bình luận.
Hãy là người bình luận đầu tiên.